プレスリリース
韓国ディープラーニング、韓国初のVLMベースのOCR「DEEP OCR+」をリリース
韓国ディープラーニング公開
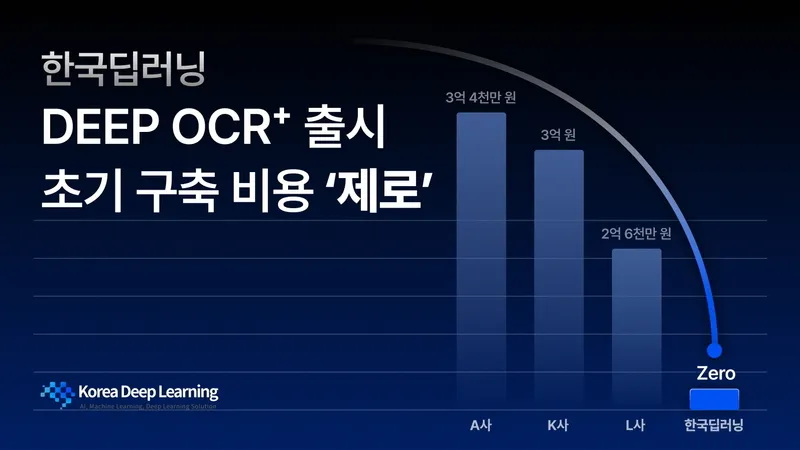
韓国ディープラーニングは2025年4月10日、韓国初の視覚言語モデル(VLM)ベースの光学文字認識(OCR)ソリューションDEEP OCR+をリリースしました。DEEP OCR+は、文書画像から文字を抜き出す従来のOCRとは異なり、文書の意味と構造を自動で分析して重要な情報を抽出するよう設計されています。数億ウォンかかっていた初期構築費用の壁をなくすことが、リリースの目標です。
表や条項の前で止まっていた従来のOCR
従来のOCRは文書画像からテキストを抽出するにとどまり、表や条項、段落のような複雑な構造を認識することが困難でした。契約書や請求書のように書式が一定でない文書では、文書ごとに個別の設計とラベリングが必要となり、その分だけ導入と維持にかかる費用も大きくなっていました。従来のOCRプロジェクトには、数億ウォン規模の費用と数か月の開発期間が必要でした。
韓国ディープラーニングは2025年2月のZDNet Koreaのインタビューで、OCRを単に文書を認識する技術ではなく、業務自動化の中核にしていくと表明しました。DEEP OCR+は、その方向性を形にした最初の製品です。
4億枚を学習したVLM
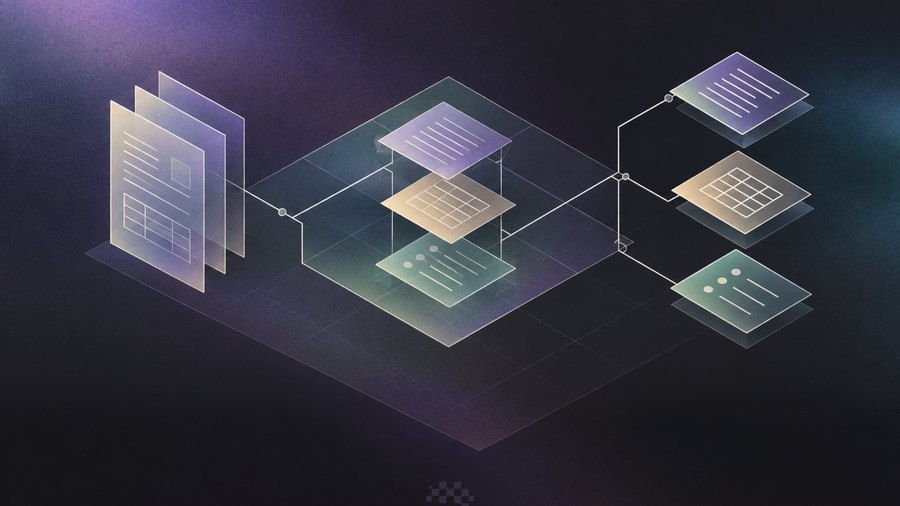
DEEP OCR+は、韓国ディープラーニングが5年間にわたり4億枚以上のテキスト・画像文書で学習させた自社のVLMを基盤としています。画像とテキストをあわせて処理するため特定のフォーマットに依存せず、書式がまちまちな非定型文書でも、追加の学習なしで主要な情報を構造化して整理します。
韓国ディープラーニングは、最近は単なる認識技術を超えて、文書内の意味や文脈まで把握できるAI技術への関心もあわせて高まっていると説明しました。今回の新製品は、こうした流れの中で文書処理技術の進化を示す事例になるとしています。
契約書からリスク条項まで抜き出すDEEP OCR+
活用方法は具体的です。契約書を入力すると、日付や金額、主要な条項を抽出し、リスクとなりうる項目を要約して示します。韓国語と英語、数字、特殊文字が混在する文書や、複雑な表・段落の構造も処理します。結果はJSONやExcelなどで書き出せるため、RPAやERPのような企業システムと連携しやすく、文書の確認と入力にかかる時間を減らして業務の自動化につながります。
平均2週間で導入、オンプレミス型・SaaS・APIの3つの提供方式
韓国ディープラーニングは、追加のデータ収集やラベリングなしでさまざまな文書タイプをすぐに処理できるため、初期導入の負担がほとんどないと説明しました。最小限のお客様データだけでも高い精度を出せるといいます。平均導入期間は2週間前後です。製品はオンプレミス型、SaaS、APIの形で提供されます。
DEEP OCRについて
韓国ディープラーニングの出発点は、文書を読むことでした。DEEP OCRは、自社開発の文書特化型VLMを基盤に、文字だけでなく文書の構造と意味をあわせて読み取る、韓国初のVLMベースのOCRソリューションです。書式がばらばらな非定型文書も、個別の学習データを構築することなく処理し、印鑑や署名、表、数字、記号といった視覚要素からテキストとキー・バリューのデータを抽出します。金融の与信書類から公共の行政文書、物流の手書き送り状まで、人が書き写していた文書がDEEP OCRを通じて業務データになります。詳しくはkoreadeep.comのDEEP OCRのページをご覧ください。
韓国ディープラーニングについて
韓国ディープラーニング(KDL)は、2019年に設立されたエンタープライズAIエージェント企業です。自社開発の文書特化型VLM「KDL Frontier」を基盤に、企業や公共機関の文書業務を担って処理するAIエージェントを開発しています。主な製品はDEEP OCR、DEEP Parser、DEEP Agent、DEEP Opsです。