プレスリリース
한국딥러닝, 서연이화에 DEEP OCR·DEEP Parser 공급해 제조 문서를 데이터로
한국딥러닝이 2026년 7월 글로벌 자동차 부품기업 서연이화의 AI 구축 사업에 DEEP OCR과 DEEP Parser를 공급해 사내 문서를 데이터로 바꾼다.
한국딥러닝이 글로벌 자동차 부품기업 서연이화의 AI 구축 사업에 참여해, 비정형 문서를 데이터로 전환하는 AI OCR과 Parser 솔루션을 공급한다. 2026년 7월 29일 공개된 이 사업은 지산소프트가 주관하고 코난테크놀로지와 한국딥러닝이 참여하며, 서연이화가 쌓아 온 사내 문서를 검색과 분석에 쓸 수 있는 데이터로 바꾸는 것이 목표다.
파일마다 흩어진 공정 정보와 설계 정보
이번 사업의 대상은 서연이화가 PDF, 이미지, 엑셀, 파워포인트 등 여러 형태로 쌓아 온 사내 문서다. 제조 기업의 공정 정보와 설계 정보는 개별 파일 안에 흩어져 있어, 필요한 내용을 찾으려면 사람이 문서를 하나씩 열어 확인하거나 다른 시스템에 다시 입력해야 했다. 표와 도면, 이미지가 섞인 제조 문서는 일반 텍스트 추출만으로는 내용과 구조를 함께 살리기 어렵다.
한국딥러닝은 이 문서들을 검색과 분석, 사내 시스템 연계에 쓸 수 있는 데이터로 바꾸는 역할을 맡는다. 흩어진 공정과 설계 정보를 검색 가능한 형태로 구조화해 문서 확인과 재입력 같은 반복 업무를 줄이고, 현장 생산성을 높이는 것이 목표다. 사업에 함께 참여하는 기업들이 구축할 AI 기반 업무 자동화도 이렇게 정리된 데이터를 바탕으로 움직이게 된다.
항목을 알아보는 OCR, 구조를 복원하는 Parser
한국딥러닝이 공급하는 광학문자인식(OCR)은 문서 이미지의 글자를 인식하는 동시에 각 내용이 어떤 항목에 해당하는지 식별해 주요 정보를 자동으로 추출한다. 글자를 읽는 데서 멈추지 않고, 읽은 값이 업무상 어떤 의미를 갖는지까지 구분하는 방식이다.
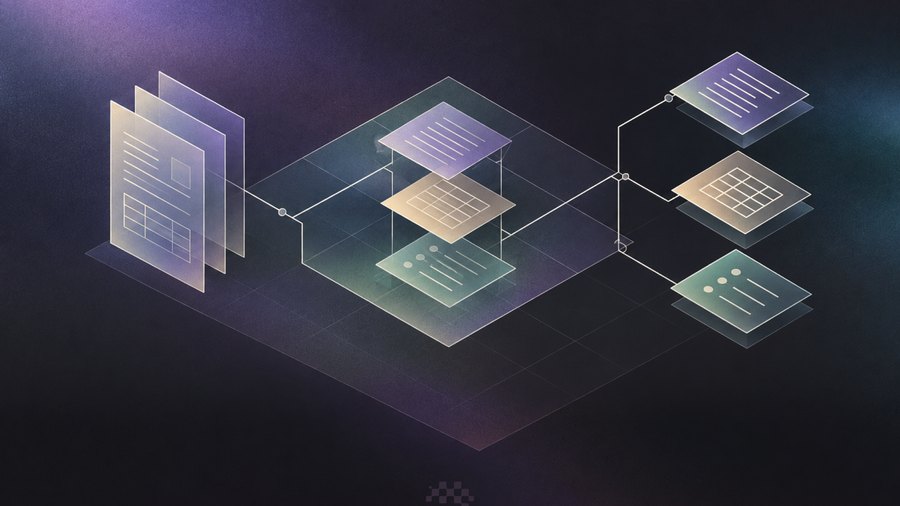
Parser는 문서의 텍스트, 표, 이미지 등 구성 요소를 15종의 레이아웃 태그로 구분하고, 각 요소의 위치와 관계를 파악해 문서 전체의 구조를 분석한다. 표 안에 또 다른 표가 들어 있거나 여러 칸이 합쳐진 복잡한 구조도 HTML 형태로 변환한다. 원본 문서의 구조와 맥락을 유지한 채 데이터베이스나 AI 시스템에서 바로 조회하고 분석할 수 있게 하는 것이다. 한국딥러닝은 이 문서 구조화 기술을 DEEP Parser(딥 파서)라는 제품으로 2025년 10월 정식 출시했다.
설계·품질·생산 정보를 하나로 관리하는 기반
한국딥러닝은 이번 사업으로 서연이화가 설계, 품질, 생산 정보를 통합 관리할 수 있는 기반을 마련하고, AI 에이전트 기술의 제조 분야 적용을 넓혀 갈 계획이다. 2025년 9월 출시한 DEEP Agent for 제조(딥 에이전트 for 제조)로 다져 온 제조 문서 처리 역량이 대형 제조사 현장에 공급되는 사례이기도 하다.
한국딥러닝은 제조 문서 자동화의 성패가 문서를 잘 읽는 데 있지 않고, AI가 문서의 구조와 맥락을 이해해 후속 업무까지 이어 갈 수 있는지에 달려 있다고 본다. 복잡한 표와 레이아웃이 뒤섞인 문서까지 실무에 쓸 수 있는 데이터로 바꿔, AI 에이전트 기반 문서 업무 자동화를 제조 현장에 구현하겠다는 입장이다.
금융과 공공에서 제조로 넓히는 AI 에이전트
한국딥러닝은 2026년 들어 AI 에이전트의 적용 분야를 꾸준히 넓혀 왔다. 2026년 4월에는 심사, 검증, 입력을 자동화하는 금융 문서 업무용 AI 에이전트를 내놓았고, 같은 달 글로벌 OCR 벤치마크에서 1위에 올랐다. 2026년 7월에는 인젠트와 손잡고 기업형 AI의 문서 활용과 검색증강생성(RAG) 정확도를 높이는 협력에 나섰으며, 금융과 공공 수요 확대에 힘입어 문서 AI 매출이 3.4배 늘었다고 밝혔다.
서연이화 사업은 이렇게 금융과 공공 시장에서 검증한 문서 이해 기술을 제조 현장으로 옮기는 사례다. 제조 문서는 공정 조건, 설계 사양, 품질 기준이 표와 도면 형태로 얽혀 있어 구조를 잃지 않고 데이터로 바꾸는 일이 특히 중요하다. 한국딥러닝은 이번 사업에서 쌓은 경험을 바탕으로 다른 제조 기업으로도 AI 에이전트 공급을 늘려 갈 계획이다.
DEEP OCR에 관해
한국딥러닝은 문서를 읽는 일에서 출발했다. DEEP OCR은 자체 문서 특화 VLM을 기반으로 글자만이 아니라 문서의 구조와 의미를 함께 읽는 국내 최초의 VLM 기반 OCR 솔루션이다. 서식이 제각각인 비정형 문서도 별도의 학습 데이터 구축 없이 처리하고, 도장과 서명, 표, 숫자, 기호 같은 시각 요소에서 텍스트와 키-값 데이터를 추출한다. 금융의 여신 서류부터 공공의 행정문서, 물류의 수기 운송장까지, 사람이 옮겨 적던 문서가 DEEP OCR을 거쳐 업무 데이터가 된다. 더 자세한 정보는 koreadeep.com의 DEEP OCR 페이지에서 확인할 수 있다.
DEEP Parser에 관해
AI가 일하려면 먼저 문서가 데이터여야 한다. DEEP Parser는 HWP·PDF처럼 AI가 직접 다루기 어려운 비정형 문서를 구조화된 데이터로 바꾸는 문서 구조화 솔루션이다. 표와 차트, 계층구조, 병합 셀까지 문서의 의미와 구조를 함께 분석해, RAG와 AI 에이전트가 활용할 수 있는 지식 데이터베이스를 만든다. 경기도청 생성형 AI 플랫폼의 행정문서 구조화로 공공 현장에서 검증됐고, 글로벌 문서 파싱 벤치마크 ParseBench VLM 부문에서 종합 1위에 올랐다. 더 자세한 정보는 koreadeep.com의 DEEP Parser 페이지에서 확인할 수 있다.
한국딥러닝 소개
한국딥러닝(KDL)은 2019년 설립된 엔터프라이즈 AI 에이전트 기업이다. 자체 문서 특화 VLM 'KDL 프론티어'를 기반으로 기업과 공공기관의 문서 업무를 맡아 처리하는 AI Worker를 만든다. 주요 제품은 DEEP OCR, DEEP Parser, DEEP Agent, DEEP Ops다.
記事を共有
- 記事テキスト
- 記事メディア画像をダウンロード
出典
- ZDNet Korea 2026-07-29
メディアお問い合わせ
韓国ディープラーニング