プレスリリース
韓国ディープラーニング、セマンティックチャンキングを導入した意味論的OCRを2026年に公開へ
韓国ディープラーニング公開
韓国ディープラーニングは、文書を意味の単位でまとめて処理するセマンティックチャンキング(Semantic Chunking)を導入した「意味論的OCR」を、2026年中に公開します。韓国ディープラーニングのキム・ドンヒョンCSO(最高戦略責任者)は、2026年2月15日に掲載されたAIタイムズのインタビューで、誤りを最小限に抑えた次世代の光学文字認識(OCR)をつくり、2026年中に全社のデータの上で動くOCRを構築するという目標を明らかにしました。
「韓国で初めて視覚言語モデル(VLM)と光学文字認識(OCR)を組み合わせたのに続き、今度は『セマンティックチャンキング(Semantic Chunking)』を導入し、誤りを最小限に抑えた『意味論的OCR』を公開します。」
— キム・ドンヒョン 韓国ディープラーニング CSO
セマンティックチャンキングはOCRの誤りをどう減らすのか
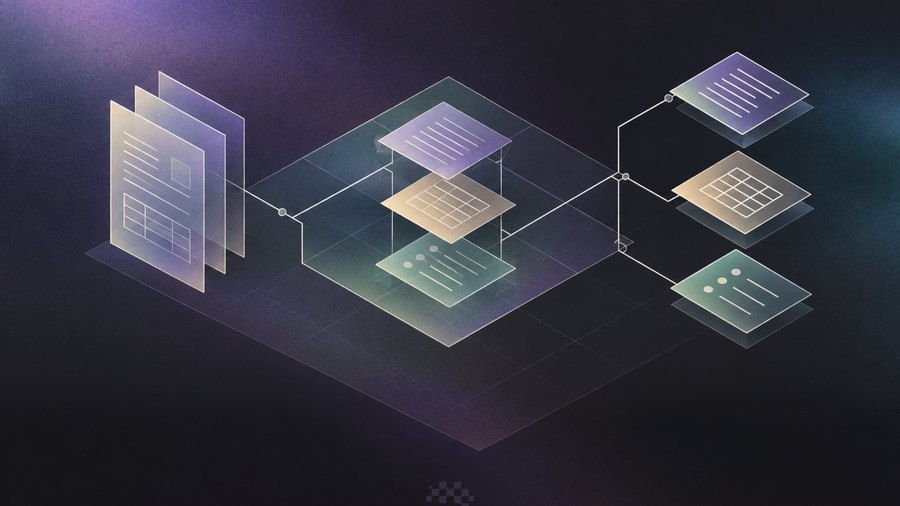
セマンティックチャンキングは、文書を文字や行の単位ではなく、意味の単位でまとめて処理する技術です。表の項目と値、条項とその内容のように、まとめて扱うべき情報を一つのかたまりとして扱えば、抽出結果が文書の本来の意味を失いません。文書を検索拡張生成(RAG)や大規模言語モデル(LLM)に供給する際に、検索の品質を左右する段階でもあります。
キムCSOは、実務にAIを取り入れるには何よりも誤りをなくすことが重要で、そのためにはAIが自ら間違いに気づけるよう、まず審査の自動化を導入すべきだと説明しました。テキストの意味を考慮したセマンティックチャンキングが鍵であり、AIで正確な根拠を引き出すには、全社のデータを「ナレッジグラフ」の形で構築する必要があるということです。
1つの文書から、全社データのナレッジグラフへ
ナレッジグラフは、1つの文書の中だけで意味を見るところから一歩進んで、ファイル間の関連性まで把握できるようにします。キムCSOは「データをナレッジグラフ化すれば、より細かい部分まで見られるようになります」と述べ、「1つの文書の中だけで意味を見るのではなく、ファイル間の関連性まで把握することで、より正確な情報検索が可能になるのです」と語りました。これまで産業の現場にこうした方式が導入されなかった理由としては、全社のデータをグラフにする過程が非常に難しく、多くのリソースがかかる点を挙げました。
VLMの導入は、まず適用できる文書の範囲を変えました。企業が扱う文書はチーム単位で見ても最大50種にのぼりますが、VLMの導入前は、特定の7~8種程度の文書にしかOCRを適用できませんでした。VLM OCRは最小限のデータでほとんどの文書を読み取れるため、ほぼすべての文書データに適用できるようになりました。韓国ディープラーニングは2025年4月、韓国初のVLMベースのOCRソリューションDEEP OCR+をリリースし、この方式をいち早く製品化しました。
文書認識から現場への投入までをつなぐエンドツーエンド
キムCSOは、文書のテキストを認識するだけではもはや十分ではないと強調しました。韓国ディープラーニングは、AIが文書データを認識してすぐに実務で使えるよう支援するエンドツーエンドのソリューションを目指しています。そのために、フォワード・デプロイド・エンジニア(FDE)が顧客企業を直接訪問し、データ構築の段階からコンサルティングを提供しています。韓国には最高データ責任者(CDO)を置いていない企業が多く、このチームがAI学習データの構築に大いに役立つという説明です。
キムCSOは「VLM OCRを業界で最も早く始めた分、実際の現場の『ニーズのポイント』をよく把握しているため、事業の拡大に有利です」と述べ、「AIの導入を検討している企業にとって、最も早く始められる方法はVLM OCRです」と語りました。
コストと性能を両立する軽量化パイプライン
VLMだけを使うとインフラのコストが増えるという限界もあります。韓国ディープラーニングは、OCRモデルとVLM OCRモデルの処理過程を組み合わせて演算量を減らしながら性能を確保する方式を選び、軽量化と量子化によって最適なモデルサイズを見つける半自動化パイプラインも整えました。4億枚のテキストと画像で学習した自社VLMを基盤に、オンプレミスでの導入期間は、システム連携を除いて1~2週間程度です。
韓国ディープラーニングは2026年1月に120億ウォン規模のシリーズAの資金調達を完了し、B200ベースのDGXサーバーを導入してインフラを拡充するとともに、開発者の採用を増やしています。キムCSOは、VLMも生成AIにあたるため、ウォーターマークなどの法的要件を守ることに気を配っていると付け加えました。2025年3月にリリースしたDEEP Agentは、2026年3月までにSaaSとしてリリースする予定です。
DEEP OCRについて
韓国ディープラーニングの出発点は、文書を読むことでした。DEEP OCRは、自社開発の文書特化型VLMを基盤に、文字だけでなく文書の構造と意味をあわせて読み取る、韓国初のVLMベースのOCRソリューションです。書式がばらばらな非定型文書も、個別の学習データを構築することなく処理し、印鑑や署名、表、数字、記号といった視覚要素からテキストとキー・バリューのデータを抽出します。金融の与信書類から公共の行政文書、物流の手書き送り状まで、人が書き写していた文書がDEEP OCRを通じて業務データになります。詳しくはkoreadeep.comのDEEP OCRのページをご覧ください。
韓国ディープラーニングについて
韓国ディープラーニング(KDL)は、2019年に設立されたエンタープライズAIエージェント企業です。自社開発の文書特化型VLM「KDL Frontier」を基盤に、企業や公共機関の文書業務を担って処理するAIエージェントを開発しています。主な製品はDEEP OCR、DEEP Parser、DEEP Agent、DEEP Opsです。