寄稿
金融AIの実体は、データの保存(DX)ではなく認知的自動化(AX)の完成度にある
韓国ディープラーニング公開
韓国ディープラーニングの未来AI開発チーム長キム・ドンヒョンが、AIタイムズに「金融AIの実体は、データの保存(DX)ではなく認知的自動化(AX)の完成度にある」を寄稿しました。
電子化が残した錯覚
寄稿はまず、金融業界のデジタルトランスフォーメーション(DX)の錯覚を指摘します。紙の文書をPDFや画像に変える電子化は、記録の保存には有効でしたが、業務の現場ではすぐに使えない非定型データを大量に積み上げる結果も招きました。インテリジェンスのないまま保存だけが増えたデータは、かえって運用の非効率を大きくするという指摘です。
「データがデジタルの規格に変換されたからといって、その中の情報がすぐに業務に活用できるわけではありません。」
筆者は、目指すべきAXを、データの中のビジネスロジックをAIが自ら把握して実行する「インテリジェンスの内在化」と定義しています。DXがアナログをデジタルに移す転換だったとすれば、AXはデータを解釈して価値を生むエンジンを備えることだという説明です。
文字を読む技術の限界と文書インテリジェンス
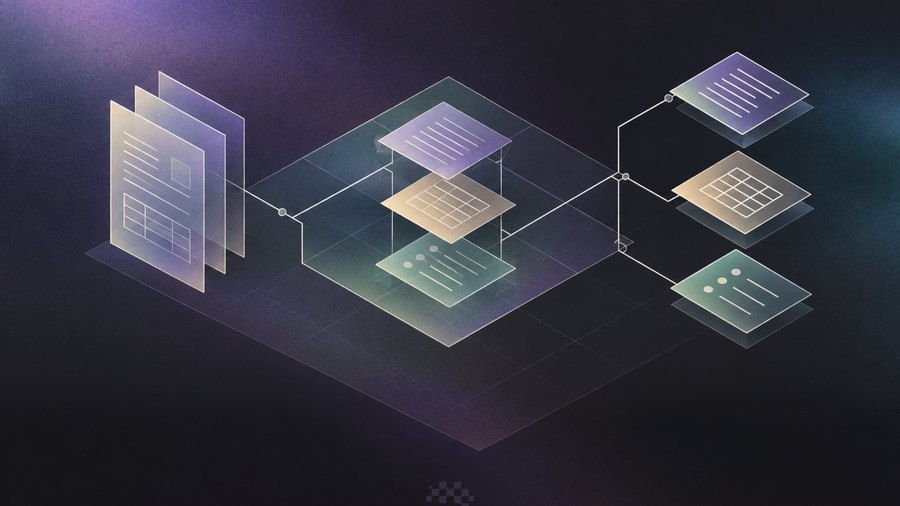
金融文書は、この違いが最もはっきり表れる領域です。保険の請求書や財務諸表のように、複雑な様式と数値の間の論理的な関係が絡み合う文書では、文字を読み取るだけのOCRは限界を見せざるを得ません。筆者は、視覚情報と言語情報をあわせて処理するVLMが、文書の構造と意味を理解する「文書インテリジェンス」を可能にするとみています。
その根拠として、自社の文書特化型VLM「KDL Frontier」のOCRBench v2の結果を挙げました。視覚的テキスト理解で85.4点を記録して8項目のうち1位となり、関係抽出では92.2点を記録し、総合順位でもグローバルなビッグテックのモデルを上回ったといいます。筆者はこれを、特定のドメインに最適化したアーキテクチャが汎用の巨大モデルよりも精緻な業務遂行を可能にする証拠と解釈し、データの量よりもドメイン学習の深さが重要だと強調しています。こうした構造の理解力は、手書き文字や複雑な様式が混在する韓国語の非定型文書にも及び、公共機関や大手金融会社の実際の環境で検証を経たと付け加えました。
金融の競争力はAXのスピードと精度
結論は、金融企業の競争力がどこから生まれるのかに集約されます。保守的な金融市場でAIの価値は精度で決まり、企業はソリューションを買うだけで終わらず、非定型データを資産に変えるAXの基準を自ら打ち立てるべきだという提言です。
「金融企業の真の競争力は、保有するデータの量ではなく、それを実質的な業務インテリジェンスに変えるAXのスピードと精度にかかっています。」
全文はAIタイムズに掲載されました。
韓国ディープラーニングについて
韓国ディープラーニング(KDL)は、2019年に設立されたエンタープライズAIエージェント企業です。自社開発の文書特化型VLM「KDL Frontier」を基盤に、企業や公共機関の文書業務を担って処理するAIエージェントを開発しています。主な製品はDEEP OCR、DEEP Parser、DEEP Agent、DEEP Opsです。