インタビュー
韓国ディープラーニング、AI性能のボトルネックは文書データの構造化にあると指摘
韓国ディープラーニング公開
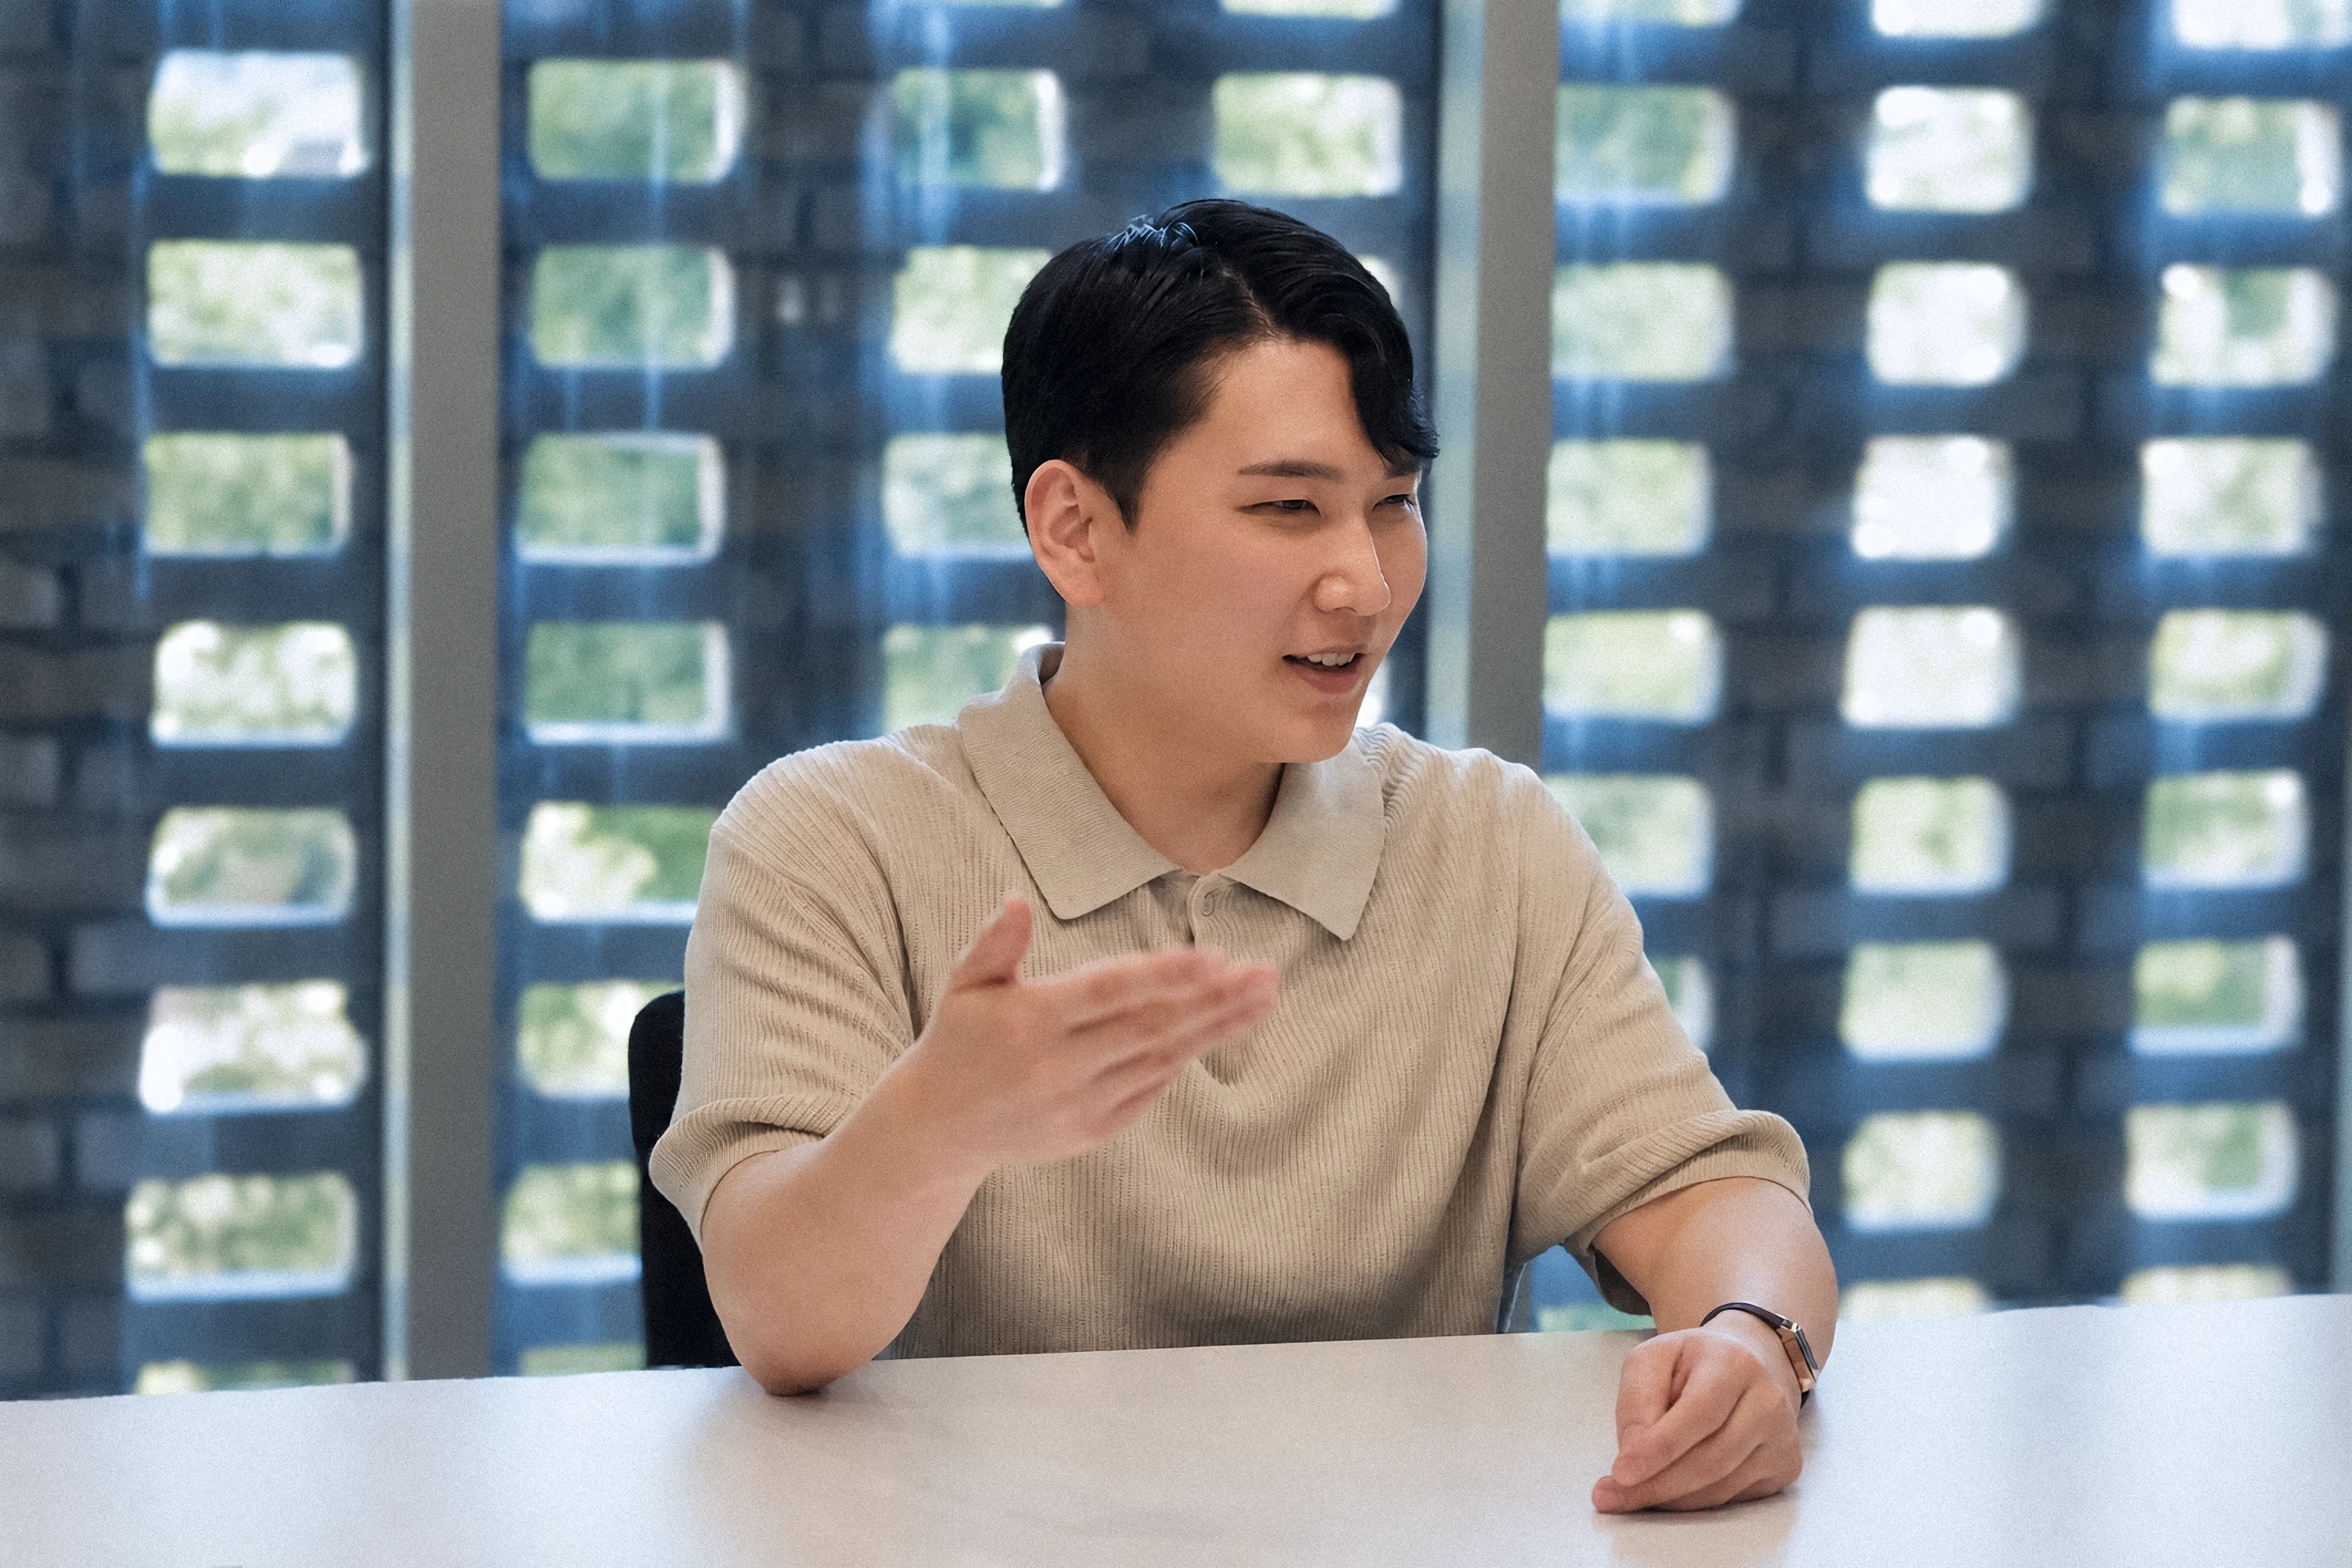
韓国ディープラーニングのキム・ジヒョン代表は、2025年12月11日の毎日日報「オ・シネのスタートアップロード」のインタビューで、AI性能のボトルネックは結局のところ文書データの構造化にあると語りました。韓国ディープラーニングは、従来の光学文字認識(OCR)が解決できなかった構造的な限界を指摘し、文書の意味と階層を解釈するAIが企業や公共の仕事のやり方を変えるとの見通しを示しました。
DXの次はドキュメントAX
インタビューの出発点は、デジタルトランスフォーメーション(DX)とAIトランスフォーメーション(AX)の区別です。紙をデジタルファイルに変える段階が終われば、次の課題はAIがそのファイルを理解して使えるようにすることだという考えです。韓国ディープラーニングは、このドキュメントAX市場を事業の最優先に置いています。
「DXが紙をPDFに変える水準にとどまっていたとすれば、これからはAIが文書を『理解できる形』にするAXが核心になるでしょう。」
— キム・ジヒョン 韓国ディープラーニング 代表
ボックス描きにとらわれた従来のOCRは、なぜ限界なのか
韓国ディープラーニングは、従来のOCRを、文書の特定の位置にボックスを描いて学習させる方式にとらわれた技術だと分析しています。企業ごとに契約書や税金計算書、申請書のデザインが異なるため、様式が変わるたびにボックスを描き直して学習させる方式では、実際の業務に適用しにくいということです。学習した文書でしか正しく読めず、新しい様式が入るたびにボックスを描き直して学習させる技術は自動化とは言いにくい、というのが韓国ディープラーニングの判断です。デザインの異なる文書でも追加学習なしで同じ性能を出すことこそが、本当の自動化だと考えています。
文書をそのまま汎用AIに入れる方法にも限界があると見ています。写真のように複雑な情報の塊である文書を丸ごと入れると、トークンが多くなりすぎて、重要な情報が抜け落ちたり見当違いの答えが出たりしやすくなります。
文書の構造化はすでに現場で検証済み
AIが読める文書をつくることは、韓国ディープラーニングが指摘したボトルネックを解消する作業です。韓国ディープラーニングは2025年8月、総額131億ウォン規模の京畿道庁の生成AIプラットフォーム構築事業でこの問題を担いました。京畿道庁の文書の90%以上がハングル(HWP)やPDFのような非定型フォーマットで、これらの文書を構造化データに変えることが事業の中心的な課題でした。
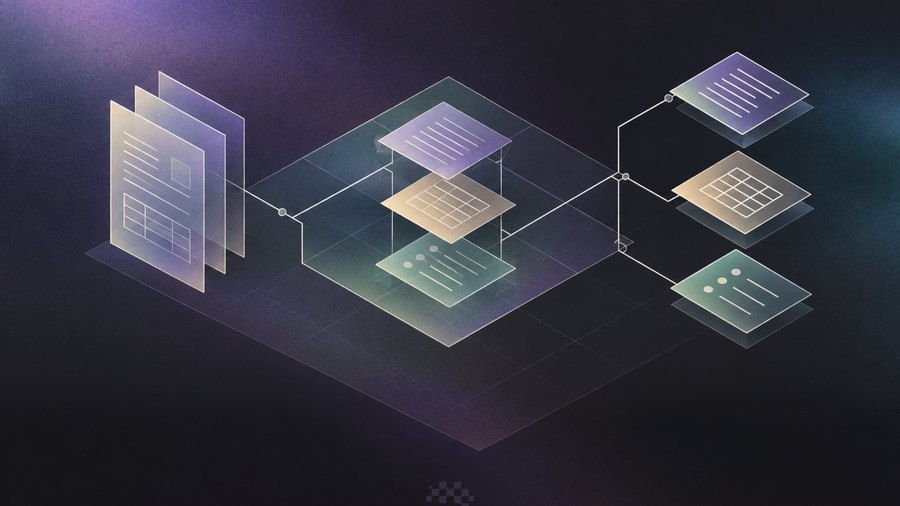
その技術は、2025年10月16日に文書構造化ソリューションDEEP Parserとして正式リリースされました。DEEP Parserは、タイトルや本文、表、キャプション、図形といった文書の要素を最大23種類に自動で分類し、PDF、HWP、JPEGのファイルをHTML、JSON、Markdown、XMLに変換します。ワイズナット、コナンテクノロジーと協力し、自治体のプロジェクトでこの構造データを各社の検索拡張生成(RAG)プラットフォームと連携させたところ、回答の精度が高まり、文書の検索速度が速くなったことが確認されました。
速度より精度、技術より現場の設計
韓国ディープラーニングの主力製品DEEP OCR+は、追加のラベリングや再学習なしに文書をすぐに処理します。4億枚以上の独自データセットで学習した自社モデルをもとに、公共機関や大企業を含む80を超える顧客にソリューションを提供しています。記事では、業務の処理時間を96%短縮し、ヒューマンエラーを15〜18%から3〜4%の水準に下げた事例や、ある公共機関で約50件の申請書類を手入力していた時間が1時間から3分に短縮された事例が紹介されました。
セキュリティが重要な分野に向けたオンプレミス(閉域網)での構築や、修士や博士レベルの技術PMをお客様に1対1で配置する「AI PMO」サービスもあわせて取り上げられました。技術を提供するだけで自動化が完成するわけではなく、それぞれの現場の制約を正確に見極め、適用できる構造を設計することが導入を本当に成功させる鍵だ、というのが韓国ディープラーニングの説明です。
文書の構造化が国の生産性を決める
韓国ディープラーニングは、言語モデルの技術が急速に進歩しても、AI性能のボトルネックは結局データの構造化にあると強調しました。文書の階層をAIが理解できるデータに変える作業が、国と産業全体の生産性を決めるという見通しです。創業6年目を迎えた韓国ディープラーニングの目標としては、ドキュメントAI市場で圧倒的な技術力を示すことを挙げました。
「人々が気づかないうちに、私たちのエージェントが世界中の文書を読み、仕事のスピードを上げる。そんな未来をつくりたいと考えています。」
— キム・ジヒョン 韓国ディープラーニング 代表
インタビューの全文は毎日日報に掲載されました。
DEEP Parserについて
AIが働くには、まず文書がデータになっている必要があります。DEEP Parserは、HWPやPDFのようにAIが直接扱いにくい非定型文書を、構造化データに変える文書構造化ソリューションです。表やグラフ、階層構造、結合セルまで、文書の意味と構造をあわせて分析し、RAGやAIエージェントが活用できるナレッジデータベースをつくります。京畿道庁の生成AIプラットフォームで行政文書の構造化を担い、公共の現場で実証されました。また、グローバルな文書パーシングのベンチマークであるParseBenchのVLM部門で総合1位を獲得しています。詳しくはkoreadeep.comのDEEP Parserのページをご覧ください。
韓国ディープラーニングについて
韓国ディープラーニング(KDL)は、2019年に設立されたエンタープライズAIエージェント企業です。自社開発の文書特化型VLM「KDL Frontier」を基盤に、企業や公共機関の文書業務を担って処理するAIエージェントを開発しています。主な製品はDEEP OCR、DEEP Parser、DEEP Agent、DEEP Opsです。