스토리
131억 원 경기도 생성형 AI 플랫폼, 시작은 모델이 아니라 문서였다
한국딥러닝은 2026년 11월 131억 원 규모 경기도 생성형 AI 플랫폼에서 HWP와 PDF 문서를 AI가 읽게 한 DEEP Parser의 역할을 되짚었다.
경기도청이 가진 문서의 90% 이상은 HWP와 PDF다. 정책 보고서와 회의록, 공문과 행정 지침서가 모두 이 두 형식으로 쌓여 있다. 사람이 열어 보면 잘 정리된 문서지만, AI에게는 안을 들여다볼 수 없는 닫힌 상자에 가깝다. 2025년 경기도가 131억 원을 들여 행정 업무 전반에 생성형 AI를 들이기로 했을 때, 가장 먼저 부딪힌 벽은 어떤 모델을 쓸지가 아니었다. 이 문서들을 AI가 읽을 수 있게 만드는 일이었다. 그 일을 한국딥러닝의 DEEP Parser가 맡았다.
전산화는 끝났지만 AI는 읽지 못했다
공공기관의 일은 문서 위에서 움직인다. 정책 검토는 보고서로 시작되고, 회의는 회의자료와 회의록으로 남으며, 행정 판단의 근거는 언제나 문서로 축적된다. 많은 행정기관이 문서 전산화를 마쳤다고 하지만, 그것은 사람이 보는 전자문서 수준이다. PDF와 HWP, 이미지 속에서 AI는 구조를 이해하지 못하고 텍스트만 읽는다. 표는 깨지고 수식은 이미지로 처리되며, 수기 입력과 서명은 데이터가 되지 못한다.
경기도만의 사정도 아니다. 위성곤 의원실의 2025년 10월 국정감사 자료 '공공분야 AI 활용 현황'에 따르면 공공기관 보유 문서의 91.1%가 AI가 활용하기 어려운 비정형 포맷으로 존재한다. 한국딥러닝은 AI타임스 기고에서 이것이 기술 부족이 아니라, 문서가 처음부터 AI가 해석할 수 있는 구조로 설계되지 않은 문제라고 짚었다. 같은 단어도 기관마다 뜻이 달라, '검토'가 어떤 곳에서는 참고 의견이고 다른 곳에서는 결재 전 공식 절차다.
"AI가 읽기 위해서는 문서가 '데이터의 언어'로 번역돼야 합니다."
— 김지현 한국딥러닝 대표
공공 부문에서도 질의응답 AI와 문서 요약, 내부 자료 검색 챗봇 같은 시도가 이어졌지만 현장의 반응은 기대만큼 뜨겁지 않았다. 문제는 AI의 성능이 아니라 AI가 읽어야 할 문서의 상태에 있었다.
광역지자체 첫 생성형 AI 행정
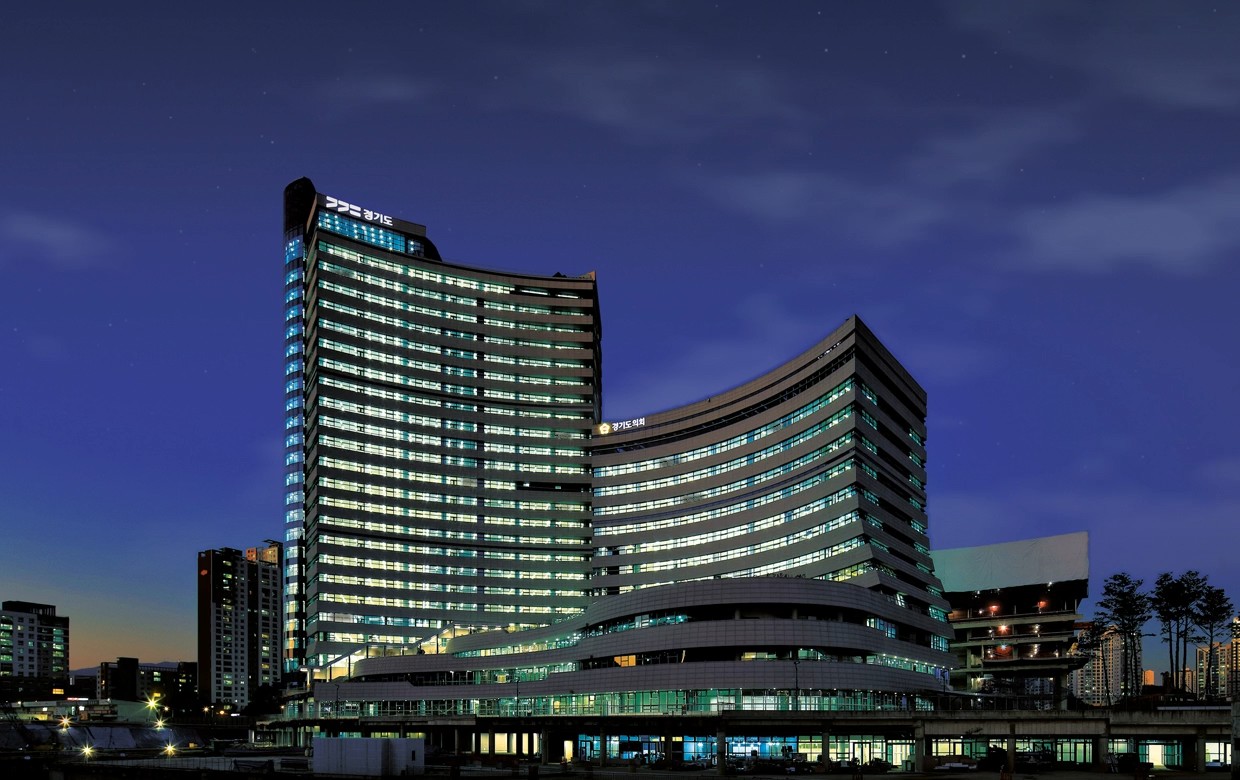
경기도청의 '2025년 생성형 AI 플랫폼 구축사업'은 총 131억 원 규모다. 전국 광역지자체 가운데 처음으로 행정 업무 전반에 생성형 AI를 본격 도입하는 사례이고, 약 11개월에 걸쳐 문서작성, 회의관리, 정보검색 등 실무 중심의 AI 업무 지원 체계를 만든다. 한국딥러닝은 AI, 빅데이터, 클라우드 전문기업 엠티데이타와 협력해 이 사업에 DEEP Parser를 공급했고, 2025년 8월 26일 이를 알렸다.
이 프로젝트에서 핵심이 된 질문은 "AI가 실제로 일을 하게 하려면 무엇부터 바꿔야 하는가"였다. 답은 시스템이 아니라 문서였다. 생성형 AI가 행정 업무를 돕는 방식은 대부분 기관이 보유한 문서를 찾아 읽고 답을 만드는 구조다. 문서가 표와 서식이 깨진 텍스트로만 들어가면, AI는 수치의 기준이나 항목 사이의 관계를 놓친 채 답을 만든다. 그래서 경기도청의 플랫폼은 문서 구조를 먼저 해결하는 방향으로 설계됐다.
한국딥러닝은 경기도청 생성형 AI 플랫폼 프로젝트를 통해 공공 부문 디지털 전환에 기여하게 된 점이 의미가 크다고 밝혔다. DEEP Parser는 AI가 문서를 이해하고 활용할 수 있도록 하는 지식 데이터베이스 구축의 핵심 기술이라는 것이 한국딥러닝의 설명이다.
글자를 옮기는 일과 문서를 이해하는 일
기존 OCR은 문서에서 텍스트를 뽑아내는 데 그쳤다. 수작업 입력을 줄인 것은 분명한 진전이었지만, 그 결과물은 글자 목록에 가깝다. 한 부처의 사업계획서에는 수십 개의 표와 그래프, 주석, 수식이 들어 있는데, OCR은 글자를 뽑아낼 수는 있어도 그 표가 어떤 정책 항목과 예산 구조를 설명하는지는 해석하지 못한다.
사람은 문서를 볼 때 제목을 먼저 보고, 표를 하나의 덩어리로 인식하며, 문단 사이의 흐름을 따라간다. 글자를 읽는 동시에 구조와 맥락을 이해하는 것이다. 문서 구조화는 이 과정을 AI에게 가능하게 만드는 일이다. 표는 표로, 문단은 문단으로, 제목은 제목으로 인식돼야 이후의 요약과 검색, 질의응답이 작동한다. 경기도청이 OCR이 아닌 구조화를 택한 이유가 여기에 있다.
DEEP Parser가 HWP와 PDF를 다루는 방식
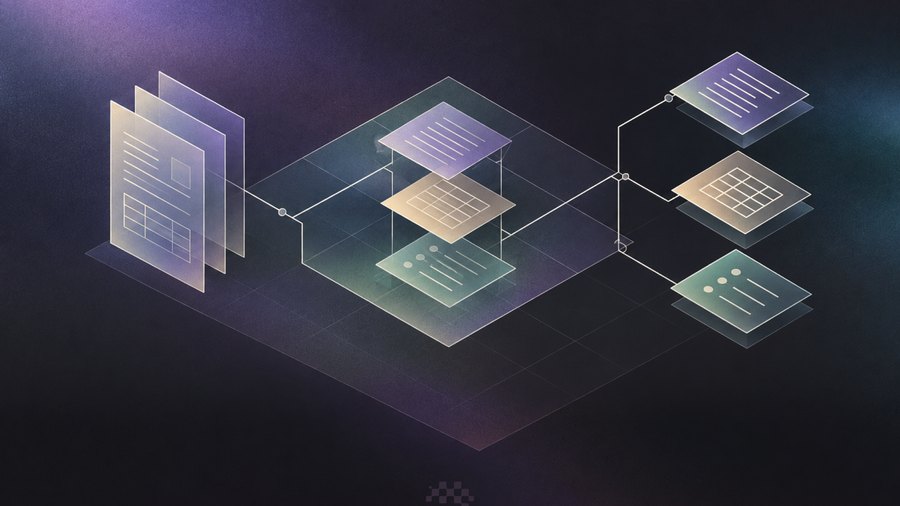
DEEP Parser는 VLM 기술로 문서의 의미와 구조를 동시에 분석한다. 문서를 이미지와 언어를 함께 가진 대상으로 보고, 표와 차트, 계층구조, 병합 셀 같은 복잡한 요소까지 인식한다. 문서를 글자 단위로 쪼개지 않고 의미 단위로 해체한 뒤 다시 조립한다. 표는 하나의 표로, 병합된 셀은 연결된 정보로, 문단은 계층 구조를 유지한 채 남는다.
2025년 10월 정식 출시된 DEEP Parser는 제목과 본문, 표, 캡션, 도형 등 문서 요소를 최대 23가지 유형으로 자동 분류하고, PDF·HWP·JPEG 파일을 HTML, JSON, 마크다운, XML로 변환한다. 대용량 문서는 AI가 처리하기 좋은 의미 단위로 자동 분할한다. 한국딥러닝이 5년간 쌓아 온 대규모 텍스트와 이미지 데이터로 학습한 자체 VLM을 기반으로 하기 때문에, 별도의 데이터 수집이나 라벨링 없이 다양한 유형의 문서를 바로 처리할 수 있다. 자체 테스트에서는 문서 항목 인식 정확도 97.3%, 데이터 추출 정확도 96%를 기록했다.
경기도청은 이 구조화 데이터 위에서 네 가지 기능을 구현한다. 비정형 문서의 정밀 디지털화와 구조화, 정책 문서와 보고서의 정보 추출 및 정제, 회의록 요약과 핵심 내용 자동 추출, 공무원을 위한 문서 기반 검색과 질의응답 서비스다. 문서 작성부터 정보 검색까지 행정 실무의 여러 단계가 구조화된 문서 데이터 위에서 움직이게 된다.
참관객이 가져온 문서를 그 자리에서
경기도청에서 열린 '경기 생성형 AI 플랫폼 구축 데모데이'는 131억 원 사업의 성과를 공개하는 자리였다. 경제부지사와 도의원, 주요 AI 스타트업 관계자 등이 참석했다. 한국딥러닝은 2025년 11월 12일 이 자리에서 DEEP Parser를 시연했다고 알렸다. 8월 공급 발표 이후 약 석 달 만에 내놓은 중간 성과였다.
한국딥러닝은 상담 부스에서 참관객이 원하는 문서나 샘플 데이터를 직접 올리면 곧바로 구조화된 결과를 확인할 수 있게 했다. 표와 차트, 계층구조, 병합 셀이 섞인 문서가 어떻게 데이터로 바뀌는지를 현장에서 그대로 보여 준 것이다. 미리 준비한 샘플이 아니라 처음 보는 문서를 즉석에서 처리할 수 있었던 것은, 새로운 유형의 문서가 들어와도 따로 학습시키지 않고 바로 다루는 구조 덕분이었다. 한국딥러닝은 실제 공공 행정 현장에서 솔루션이 어떻게 쓰이는지를 직접 보여 줄 수 있었던 점이 의미 있었다고 말했다.
한국딥러닝은 경기도청 사례를 시작으로 전국 지자체 및 공공기관으로 솔루션 공급을 지속 확대해 나갈 계획이다.
다른 공공기관이 이 사례에서 읽어야 할 것
경기도청 사례가 남긴 것은 순서에 대한 답이다. 생성형 AI 도입에서 먼저 설계해야 할 대상은 모델이 아니라 문서다. 경기도청이 그랬듯 대부분의 공공기관이 HWP와 PDF 문서를 안고 있고, DEEP Parser는 특정 양식에 의존하지 않기 때문에 중앙부처와 기초지자체, 공공기관 전반으로 같은 구조를 옮겨 적용할 수 있다. 보안이 중요한 내부망 환경에는 온프레미스 방식으로도 설치할 수 있다.
검증은 경기도 밖으로도 이어졌다. 한국딥러닝은 와이즈넛, 코난테크놀로지와 협력 체계를 갖춰 지자체 프로젝트에서 DEEP Parser가 만든 구조 데이터를 각 사의 RAG·검색 플랫폼과 연동했고, 사용자 질문에 대한 답변 정확도가 높아지고 문서 검색 속도가 빨라진 것을 확인했다. 2026년에는 운영 플랫폼 DEEP Ops가 나와, 도입 이후 담당자가 추출 기준을 자연어로 바꾸고 같은 문서에서 버전별 성능을 비교·검증할 수 있게 됐다. 규정과 서식이 자주 바뀌는 행정 환경에서 외부 개발에 기대지 않고 플랫폼을 내부에서 다듬을 수 있다는 뜻이다.
구조화가 끝난 문서는 보관 대상에서 계속 꺼내 쓰는 지식 자산이 된다. 자료를 찾고 정리하는 시간이 줄면, 공무원은 그 시간을 정책 판단과 의사결정에 쓸 수 있다. 한국딥러닝이 기고에서 내린 결론도 같은 곳을 가리킨다.
"행정의 병목은 새로운 시스템의 부재가 아니라, AI가 이해할 수 있는 형태로 데이터를 준비하지 않은 데 있습니다."
— 김지현 한국딥러닝 대표
DEEP Parser에 관해
AI가 일하려면 먼저 문서가 데이터여야 한다. DEEP Parser는 HWP·PDF처럼 AI가 직접 다루기 어려운 비정형 문서를 구조화된 데이터로 바꾸는 문서 구조화 솔루션이다. 표와 차트, 계층구조, 병합 셀까지 문서의 의미와 구조를 함께 분석해, RAG와 AI 에이전트가 활용할 수 있는 지식 데이터베이스를 만든다. 경기도청 생성형 AI 플랫폼의 행정문서 구조화로 공공 현장에서 검증됐고, 글로벌 문서 파싱 벤치마크 ParseBench VLM 부문에서 종합 1위에 올랐다. 더 자세한 정보는 koreadeep.com의 DEEP Parser 페이지에서 확인할 수 있다.
한국딥러닝 소개
한국딥러닝(KDL)은 2019년 설립된 엔터프라이즈 AI 에이전트 기업이다. 자체 문서 특화 VLM 'KDL 프론티어'를 기반으로 기업과 공공기관의 문서 업무를 맡아 처리하는 AI Worker를 만든다. 주요 제품은 DEEP OCR, DEEP Parser, DEEP Agent, DEEP Ops다.
기사 공유
- 기사 텍스트
- 기사 미디어이미지 내려받기
출처
- 벤처스퀘어 2025-08-26
- 인공지능신문 2025-08-26
- 헬로티 2025-10-16
- AI타임스 2025-10-31
- 디지털투데이 2025-11-12
- 한국딥러닝 블로그 2026-09-08
미디어 문의
한국딥러닝