기고
텍스트만 읽는 AI는 한계, 이미지까지 이해하는 VLM 시대가 왔다
한국딥러닝은 2025년 4월 30일 지디넷코리아 기고에서 텍스트만 읽는 거대언어모델(LLM)의 한계를 짚고, 이미지까지 이해하는 비전언어모델(VLM)이 산업 현장의 문서 처리를 바꾸는 'VLM 시대'가 왔다고 밝혔다. 기고는 LLM이 등장한 지 2년이 채 안 된 시점에 산업계의 관심이 VLM으로 옮겨 가고 있다고 진단한다.
LLM은 스캔 문서를 직접 읽지 못한다
기고가 짚은 LLM의 한계는 분명하다. LLM은 픽셀로 이뤄진 시각 정보를 직접 해석하지 못한다. 스캔한 문서는 먼저 광학문자인식(OCR)으로 텍스트로 바꿔야 LLM이 다룰 수 있다.
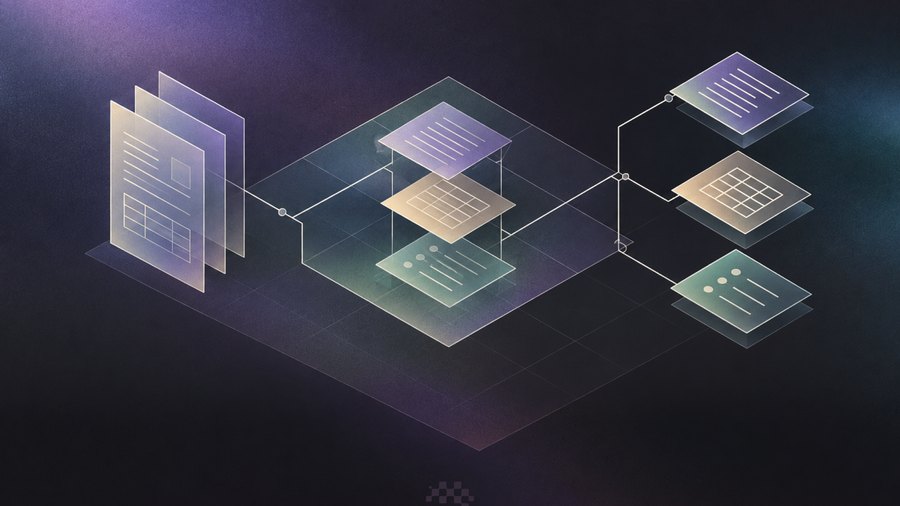
VLM은 이 간극을 메운다. 기고는 VLM을 '사진 전문가'와 '언어 전문가'에 비유해 설명한다. 이미지를 보는 능력과 글을 해석하는 능력을 함께 갖췄기 때문에, 글자가 흐릿한 금액 칸에서도 주변 맥락을 보고 '이 칸은 청구 금액일 것'이라고 추론할 수 있다는 것이다.
하루 4만 장 송장과 보험 심사에서 확인한 효과
기고는 두 가지 현장 사례로 효과를 설명한다. 하루 평균 4만 장의 송장을 스캔하는 물류기업 L사는 송장 양식이 600종을 넘어서면서 OCR 오류율이 18%까지 올랐다. VLM 기반 OCR을 도입한 첫 달 오류율은 4%로 떨어졌고, 검수 인력은 15명에서 4명으로 줄었다.
보험 손해 사정 워크플로에서는 VLM 기반 OCR을 도입한 지 3개월 만에 건당 평균 심사 시간이 4.7분 줄었고, 부실 청구 탐지율은 2.3배로 높아졌다.
VLM 도입의 세 가지 과제와 규제
기고는 VLM을 실제 업무에 들이는 데 풀어야 할 과제로 GPU 비용, 데이터 보안, 머신러닝 운영(ML옵스) 통합을 꼽는다. 규제 환경도 변수다. 유럽연합(EU)의 AI법이 이미지 데이터의 편향성과 프라이버시를 규정하기 시작했다는 점도 짚는다.
한국딥러닝은 이 방향을 제품으로 옮겨 2025년 3월 DEEP Agent(딥 에이전트)를, 2025년 4월 10일 VLM 기반 OCR 솔루션 DEEP OCR+를 출시했다.
기고 전문은 지디넷코리아에 실렸다.
한국딥러닝 소개
한국딥러닝(KDL)은 2019년 설립된 엔터프라이즈 AI 에이전트 기업이다. 자체 문서 특화 VLM 'KDL 프론티어'를 기반으로 기업과 공공기관의 문서 업무를 맡아 처리하는 AI Worker를 만든다. 주요 제품은 DEEP OCR, DEEP Parser, DEEP Agent, DEEP Ops다.
기사 공유
- 기사 텍스트
미디어 문의
한국딥러닝