기고
공공데이터 91%, 문서 구조화 없이는 AI가 읽지 못해
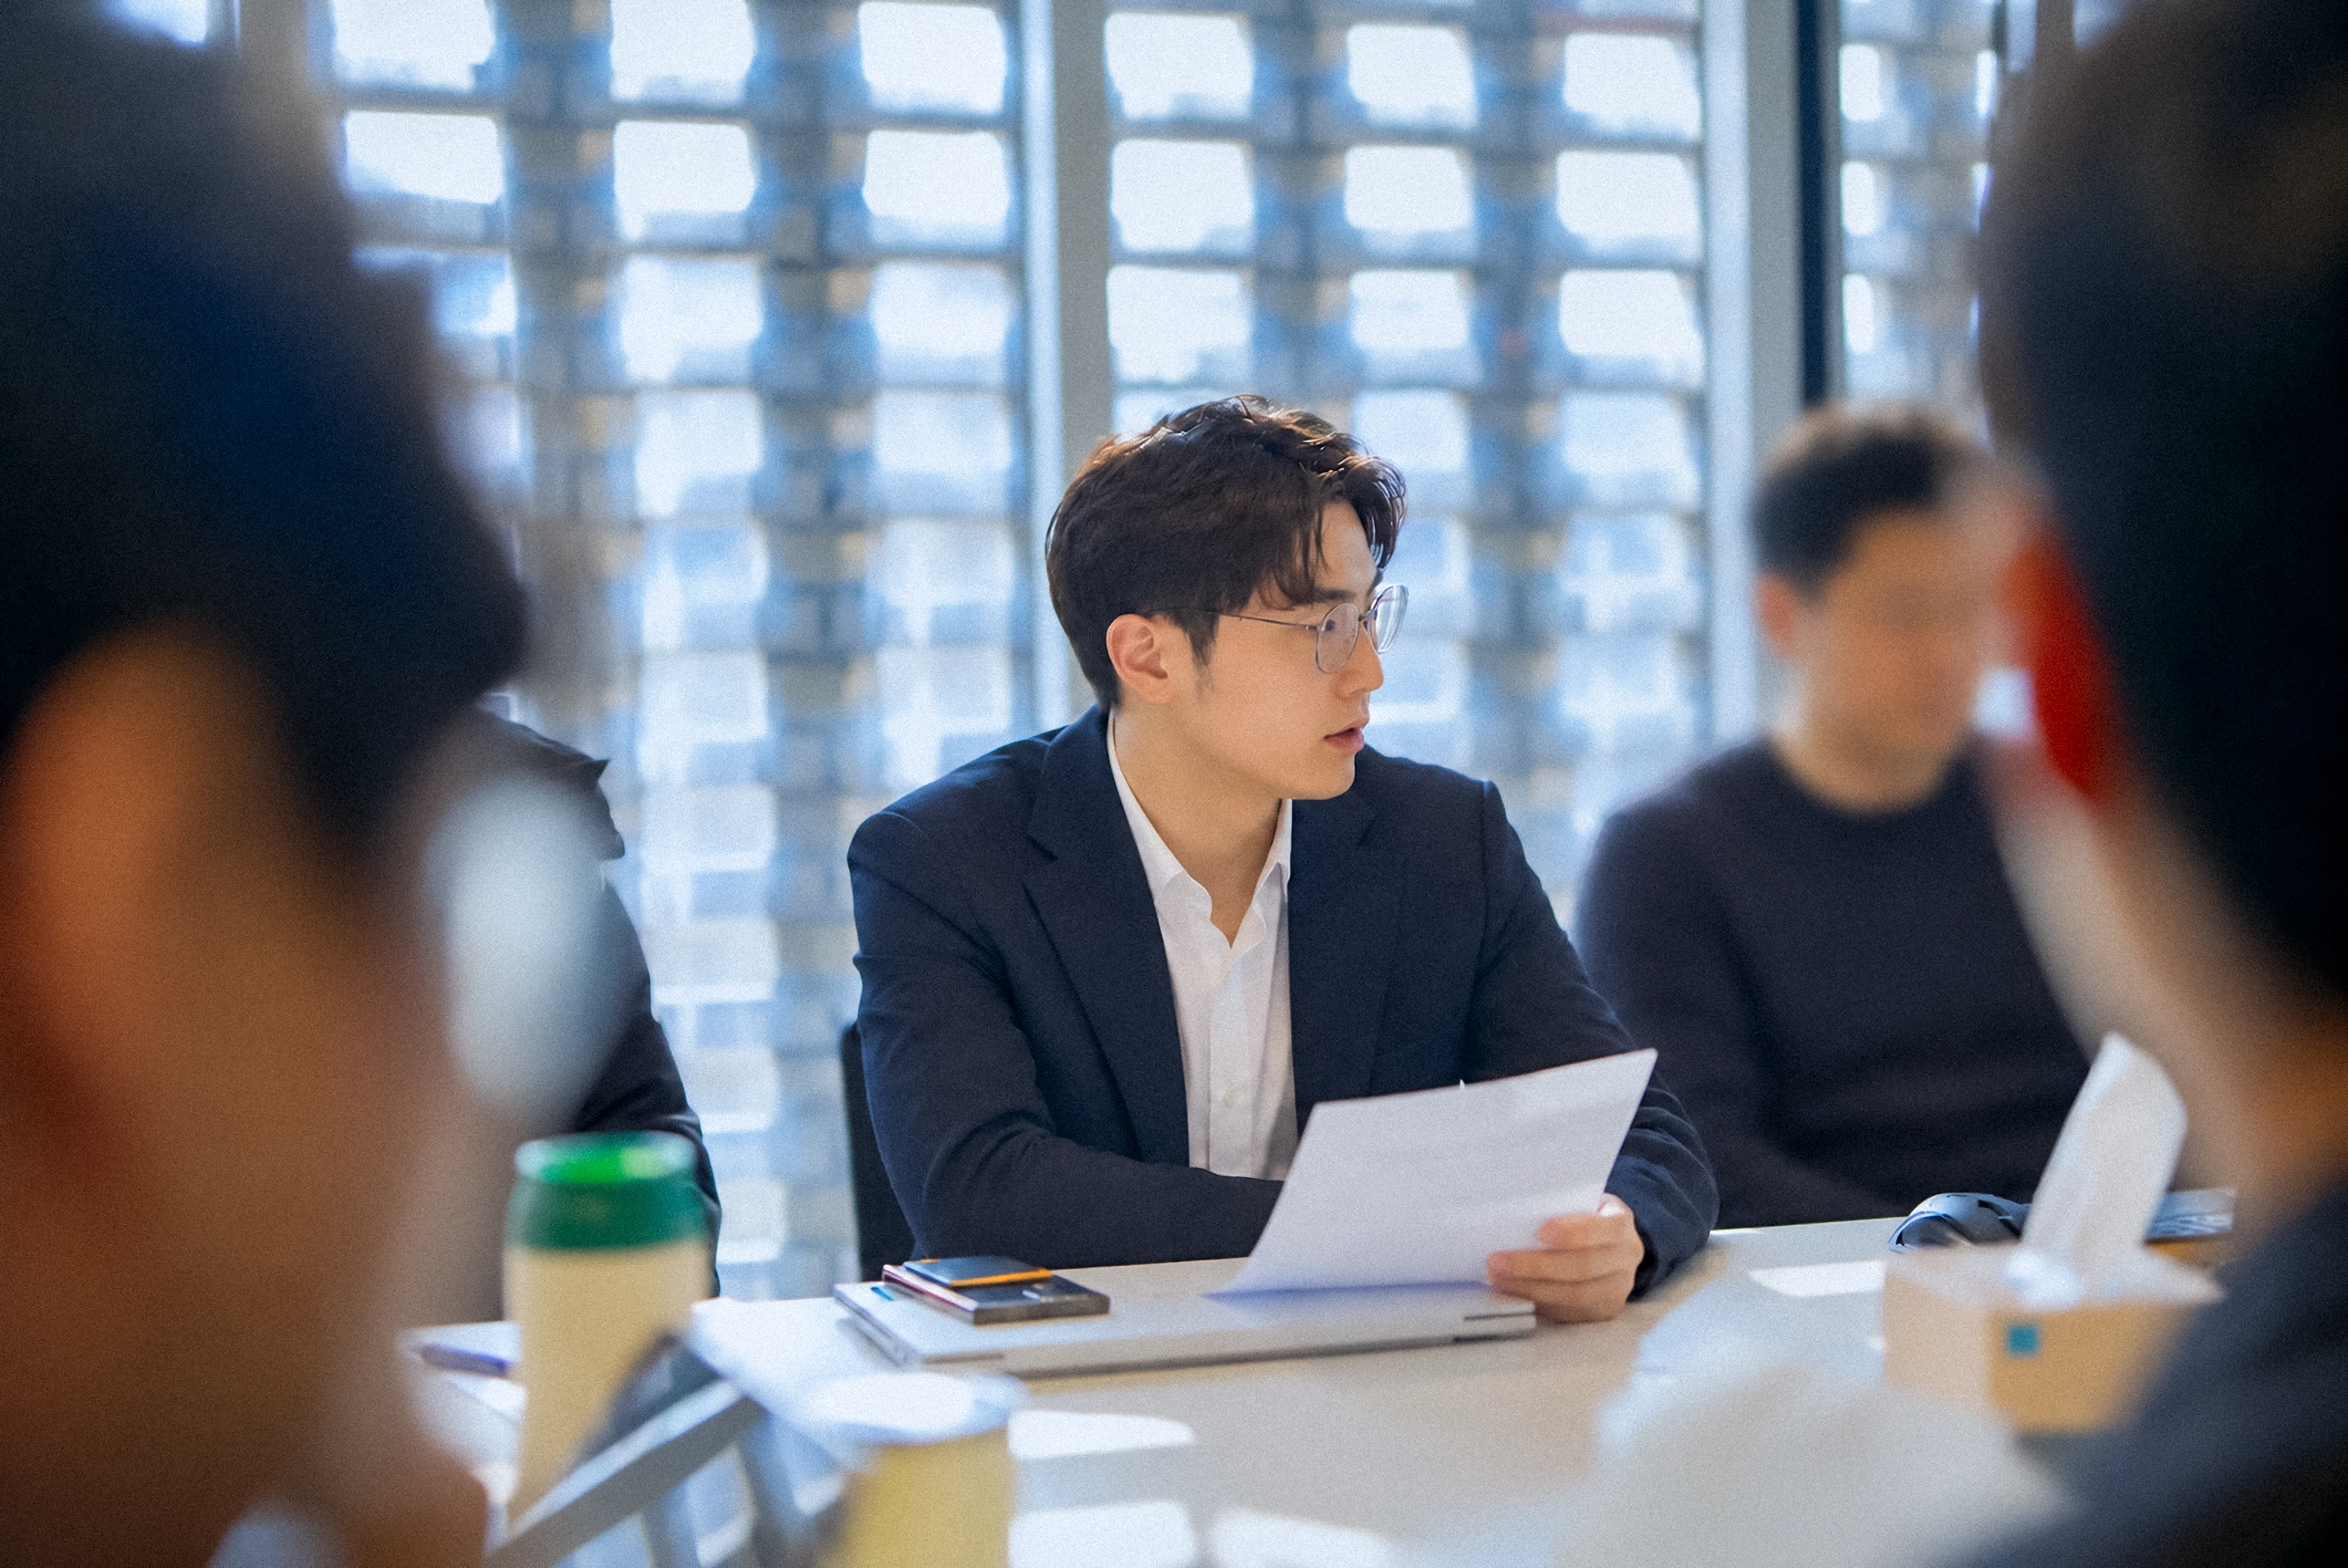
한국딥러닝은 2025년 10월 AI타임스 기고에서 공공기관 문서의 91.1%가 비정형이라며 AI 행정에는 문서 구조화가 필요하다고 짚었다.
한국딥러닝 김지현 대표가 AI타임스에 '공공데이터 91%, 문서 구조화 없이는 AI가 읽지 못해'를 기고했다.
전산화는 끝났지만 AI는 읽지 못한다
기고는 정부가 디지털 전환(DX)에서 행정 전 과정에 AI를 들이는 '행정 전환'으로 나아가는 길목의 간극을 짚는다. 많은 행정기관이 문서 전산화를 마쳤다고 하지만, 그것은 사람이 보는 전자문서 수준이다. PDF와 HWP, 이미지 속에서 AI는 구조를 이해하지 못하고 텍스트만 읽는다. 표는 깨지고 수식은 이미지로 처리되며, 수기 입력과 서명은 데이터가 되지 못한다. 필자는 AI의 관점에서 행정 문서의 90% 이상이 '데이터 사각지대'에 있다고 본다.
91.1%가 비정형이라는 현실
근거로 든 것은 위성곤 의원실의 2025년 10월 국정감사 자료 '공공분야 AI 활용 현황'이다. 공공기관 보유 문서의 91.1%가 AI가 활용하기 어려운 비정형 포맷으로 존재한다는 내용이다. 필자는 이것이 기술 부족이 아니라 문서가 처음부터 AI가 해석할 수 있는 구조로 설계되지 않았다는 문제라고 해석한다.
예시도 든다. 한 부처의 사업계획서에는 수십 개의 표와 그래프, 주석, 수식이 들어 있다. OCR은 글자를 뽑아낼 수 있지만, 그 표가 어떤 정책 항목과 예산 구조를 설명하는지는 해석하지 못한다. 같은 단어가 기관마다 다른 뜻을 갖기도 한다. '검토'는 어떤 기관에서는 참고 의견이지만 다른 기관에서는 결재 전 공식 절차다. 그래서 텍스트 인식에서 나아가 문서의 구조와 관계를 파악하는 '의미 단위의 구조화'가 필요하다는 것이다.
"AI가 읽기 위해서는 문서가 '데이터의 언어'로 번역돼야 합니다."
— 김지현 한국딥러닝 대표
병목은 기술이 아니라 데이터의 언어
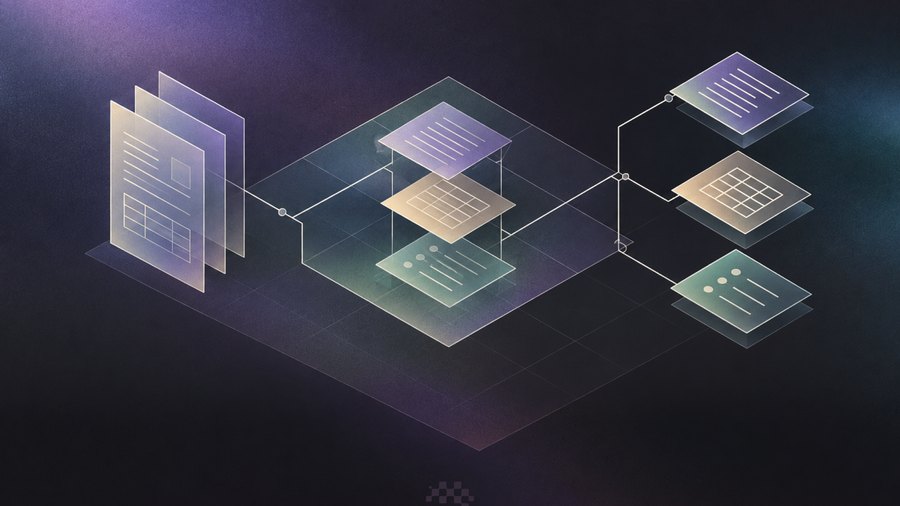
기존 행정 데이터는 사람이 읽도록 작성됐지만, AI는 구조가 명시적으로 표현돼야 해석할 수 있다. AI에게는 줄바꿈과 표의 열 순서, 항목의 위치가 모두 의미를 갖는다. 필자가 제시하는 해법은 문서 구조화다. 파싱으로 레이아웃과 항목 관계, 표의 계층, 문단 흐름을 분석해 AI가 이해할 수 있는 형태로 바꾸는 과정이다. 한국딥러닝의 DEEP Agent+는 텍스트와 표, 수식, 도형, 주석, 레이아웃을 통합 분석해 문서 구조를 복원하고, 비정형 문서를 데이터베이스로 만들어 검색과 요약, 분류, 통계 분석에 쓰게 한다.
행정 효율화는 구조화에서 시작된다
결론은 AI를 들인다고 행정이 저절로 효율화되지는 않는다는 것이다. 속도와 정확도는 데이터의 준비도에 달려 있고, 문서를 전자파일로 바꾸는 것만으로는 AI가 읽는 데이터가 되지 않는다. 데이터는 보관 대상이 아니라 이해와 판단의 원천이 돼야 한다는 주장이다.
"행정의 병목은 새로운 시스템의 부재가 아니라, AI가 이해할 수 있는 형태로 데이터를 준비하지 않은 데 있습니다."
전문은 AI타임스에 실렸다.
한국딥러닝 소개
한국딥러닝(KDL)은 2019년 설립된 엔터프라이즈 AI 에이전트 기업이다. 자체 문서 특화 VLM 'KDL 프론티어'를 기반으로 기업과 공공기관의 문서 업무를 맡아 처리하는 AI Worker를 만든다. 주요 제품은 DEEP OCR, DEEP Parser, DEEP Agent, DEEP Ops다.
기사 공유
- 기사 텍스트
- 기사 미디어이미지 내려받기
출처
- AI타임스 2025-10-31
미디어 문의
한국딥러닝