인터뷰
한국딥러닝, 대출 서류 입력 3만 시간을 1,000시간으로 줄인 방법
한국딥러닝은 2026년 4월 EBN 인터뷰에서 DEEP Agent가 대형 캐피탈사의 대출 서류 입력 시간을 약 96% 줄였다고 밝혔다.
한국딥러닝의 비전언어모델(VLM) 기반 AI 에이전트 DEEP Agent(딥 에이전트)는 기술 실증(PoC) 시뮬레이션에서 국내 대형 캐피탈사의 대출 서류 입력 시간을 월 3만 시간에서 약 1,000시간으로, 약 96% 줄였다. 김지현 한국딥러닝 대표는 EBN 인터뷰에서 AI의 실력은 벤치마크 점수가 아니라 이렇게 줄어든 실무자의 시간으로 증명된다고 말했다.
벤치마크 점수보다 검수 시간
한국딥러닝은 AI 모델의 성능을 평가하는 기준을 현장의 시간에 둔다. 사람이 서류를 읽고 옮겨 적던 반복 업무를 AI 에이전트가 맡으면, 실무자는 예외 건의 검수와 판단에만 집중할 수 있다는 것이다.
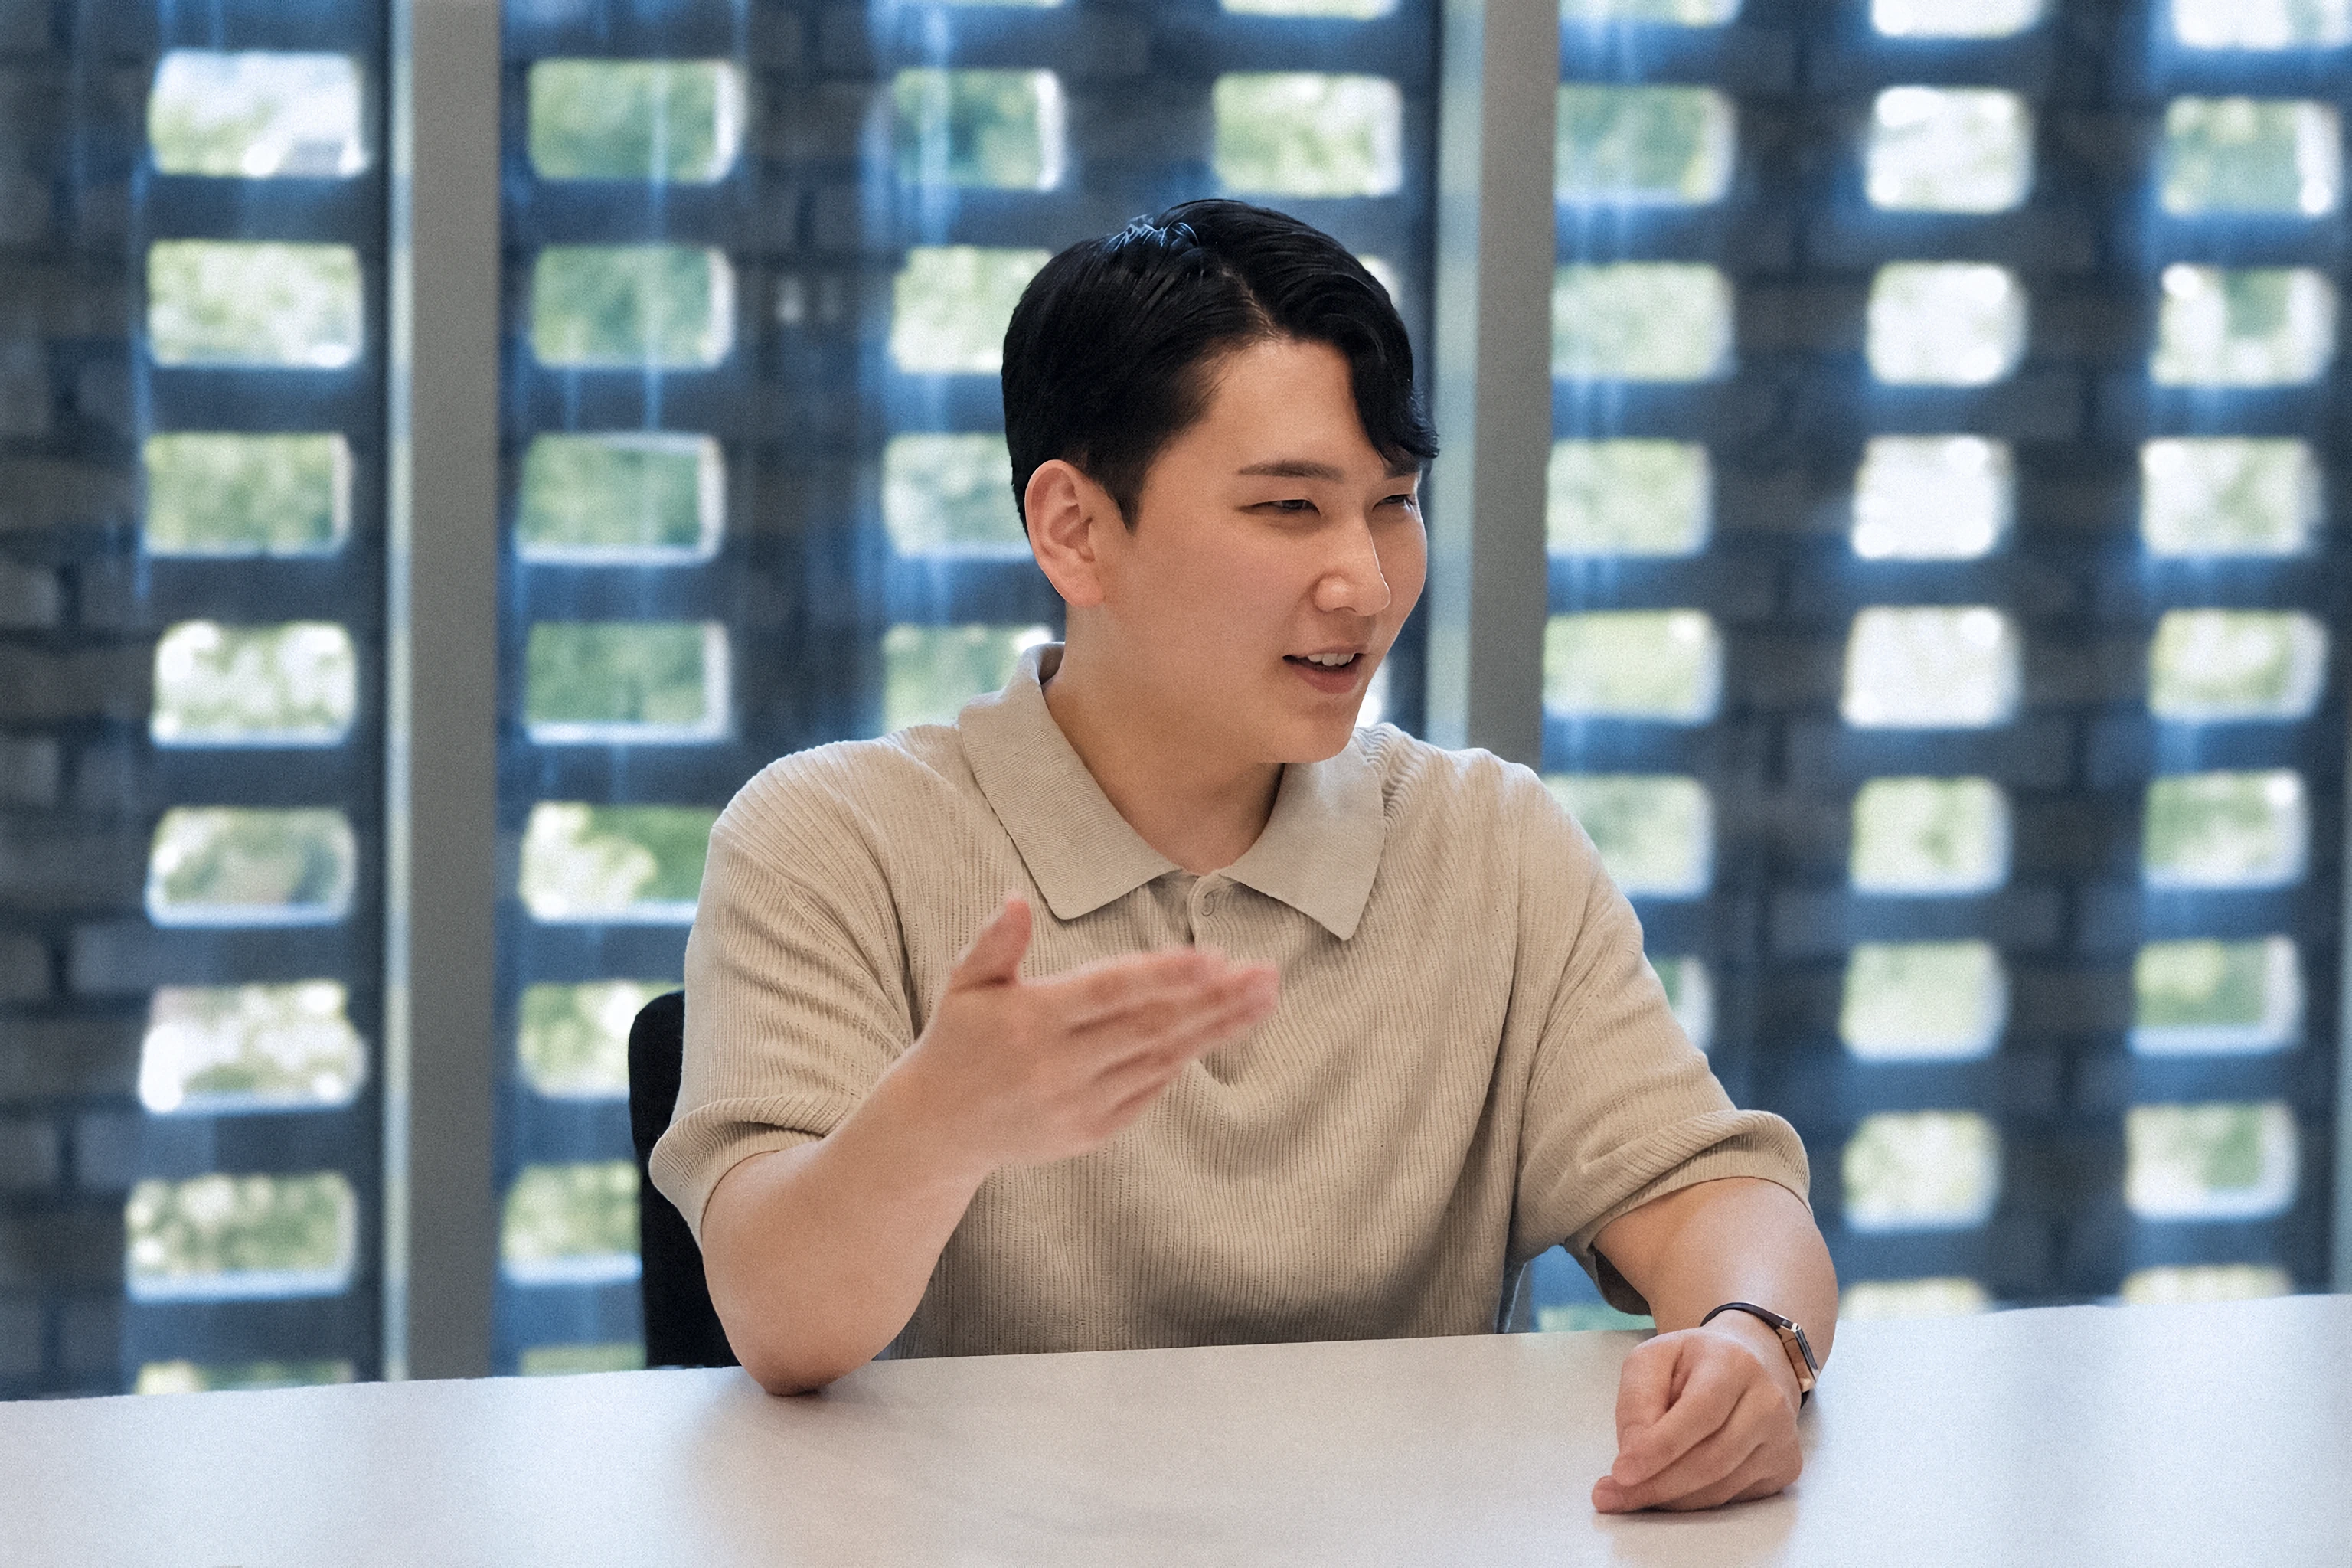
"인공지능(AI) 모델의 벤치마크 점수가 99점이냐 95점이냐는 실제 현업에서 중요하지 않습니다. 제한된 환경을 위한 점수 올리기보다 중요한 것은 실무자의 검수 시간을 얼마나 줄여주느냐입니다."
— 김지현 한국딥러닝 대표
점수를 경계하는 말이지만, 한국딥러닝이 점수에 약한 회사는 아니다. 이 인터뷰가 실리기 하루 전인 2026년 4월 22일, 한국딥러닝의 문서 특화 VLM 'KDL 프론티어'가 글로벌 멀티모달 OCR 벤치마크 OCRBench v2 영어 부문에서 종합 68.1점으로 1위에 올랐다. 2위인 구글 '제미나이 3 프로 프리뷰'를 4.7점 차로 앞섰고, GPT-5보다도 높은 점수였다. 점수로도 이기는 회사가 점수보다 시간을 먼저 말한 것이다.
환각을 억제해야 다시 보지 않는다
기존 OCR이 텍스트의 위치를 기준으로 정보를 찾았다면, DEEP Agent는 문서의 구조와 문맥, 정보 사이의 관계를 분석해 서식이 바뀌어도 필요한 값을 찾아낸다. 금액이나 개인정보를 잘못 읽는 일이 허용되지 않는 금융·공공 문서에서는 환각을 최소화하는 것이 경쟁력의 중심이라는 설명이다.
한국딥러닝은 문서 특화 VLM을 통해 환각을 억제함으로써 실무자가 모든 항목을 다시 검토해야 하는 번거로움을 없앴다고 설명했다.
한국딥러닝은 문서에 적힌 값을 최대한 그대로 추출하도록 모델을 설계해 환각을 줄였고, 이를 '니어-제로 할루시네이션'이라고 부른다. 한국어 손글씨처럼 노이즈가 많은 입력에서도 안정적으로 읽도록 최적화했다. AI의 결과를 믿지 못해 사람이 처음부터 다시 확인해야 한다면, 자동화로 아낀 시간은 검수에서 고스란히 되돌아간다. 환각을 줄이는 일이 곧 시간을 지키는 일인 이유다. 기사는 보이스피싱 피해구제 신청 서류를 AI가 즉시 추출해 입력하는 사례도 함께 소개했다.
노트북 한 대로 증명하는 현장
한국딥러닝에 따르면 고객사의 절반 이상은 다른 OCR 도입에 실패한 뒤 한국딥러닝을 찾았다. 2년 가까이 씨름하다가 기술적으로 처리가 불가능하다는 판정까지 받은 기업도 많았다고 했다.
"우리가 현장에 노트북 한 대만 들고 찾아가 처리가 안 된다는 문서를 즉석에서 바로 해독해 보여주면, 실무자들이 놀랄 정도입니다."
— 김지현 한국딥러닝 대표
처음 보는 문서를 그 자리에서 읽어 내는 힘은 제품 전략으로 이어진다. DEEP Agent는 별도의 학습 과정 없이 평균 2주 이내에 현장에 도입된다. 고객사가 데이터를 모으고 라벨을 붙이며 몇 달을 기다릴 필요가 없다는 뜻이다.
투자 없이 쌓은 100억 원
한국딥러닝은 5년간 누적 매출 100억 원을 기록했고, 경기도청과 부산시를 포함해 80곳 이상의 공공·기업 환경에 솔루션을 도입했다. 설립 후 팁스(TIPS) 지원금 1억 원 외에는 외부 투자 없이 자체 매출로 쌓은 숫자다. 첫 대규모 투자인 120억 원 규모 시리즈A에는 KDB산업은행이 50억 원으로 참여했다. 한국딥러닝은 2026년 단일 연도 매출 100억 원 돌파를 목표로 삼았다.
파트너 영업망과 글로벌 로드맵
성장 전략은 기술 입소문에서 파트너 생태계로 옮겨 가고 있다. 로드맵은 악필·필기체 같은 예외 데이터 처리 안정화, 설계 도면 등 복잡한 시각 정보 분석으로의 확장, 미국·일본·싱가포르 진출, 문서 파싱 글로벌 표준 정립 순으로 짜였다. 2027년을 목표로 한 상장에 대해서는 밸류에이션과 시장 상황을 보며 유연하게 판단하겠다는 입장을 밝혔다.
한국딥러닝은 기존에는 기술력 기반의 입소문으로 고객사를 확보했다면, 2026년부터는 전략적 파트너사를 대거 모집하고 영업망을 구축해 시장 점유율을 끌어올리겠다고 밝혔다. 전자결재나 챗GPT가 처음 도입됐을 때처럼, 훗날 실무자들이 한국딥러닝 솔루션 없이 예전엔 어떻게 일했느냐고 되묻게 되는 필수 기술 생태계를 만드는 기업으로 남고 싶다고 덧붙였다.
인터뷰 전문은 EBN에 실렸다.
DEEP Agent에 관해
한국딥러닝은 문서를 읽는 데서 멈추지 않는 AI를 만든다. DEEP Agent는 문서의 시각 구조와 언어 의미를 동시에 해석해 핵심 정보를 추출하고, 분류와 검증, 업무 시스템 연계까지 문서 업무의 전 과정을 수행하는 문서 기반 AI 에이전트다. 계약서를 올리면 핵심 조항을 요약하고 리스크 조항을 짚어내며 ERP 등록까지 이어 주고, 별도의 학습 과정 없이 평균 2주 이내에 현장에 도입된다. 국가 공인 소프트웨어 품질 인증인 GS인증 1등급을 받아 공공기관 우선구매 대상으로 지정됐다. 더 자세한 정보는 koreadeep.com의 DEEP Agent 페이지에서 확인할 수 있다.
한국딥러닝 소개
한국딥러닝(KDL)은 2019년 설립된 엔터프라이즈 AI 에이전트 기업이다. 자체 문서 특화 VLM 'KDL 프론티어'를 기반으로 기업과 공공기관의 문서 업무를 맡아 처리하는 AI Worker를 만든다. 주요 제품은 DEEP OCR, DEEP Parser, DEEP Agent, DEEP Ops다.
기사 공유
- 기사 텍스트
- 기사 미디어이미지 내려받기
미디어 문의
한국딥러닝