ストーリー
투자 없이 5년 흑자, 한국딥러닝이 AI 에이전트 기업이 되기까지
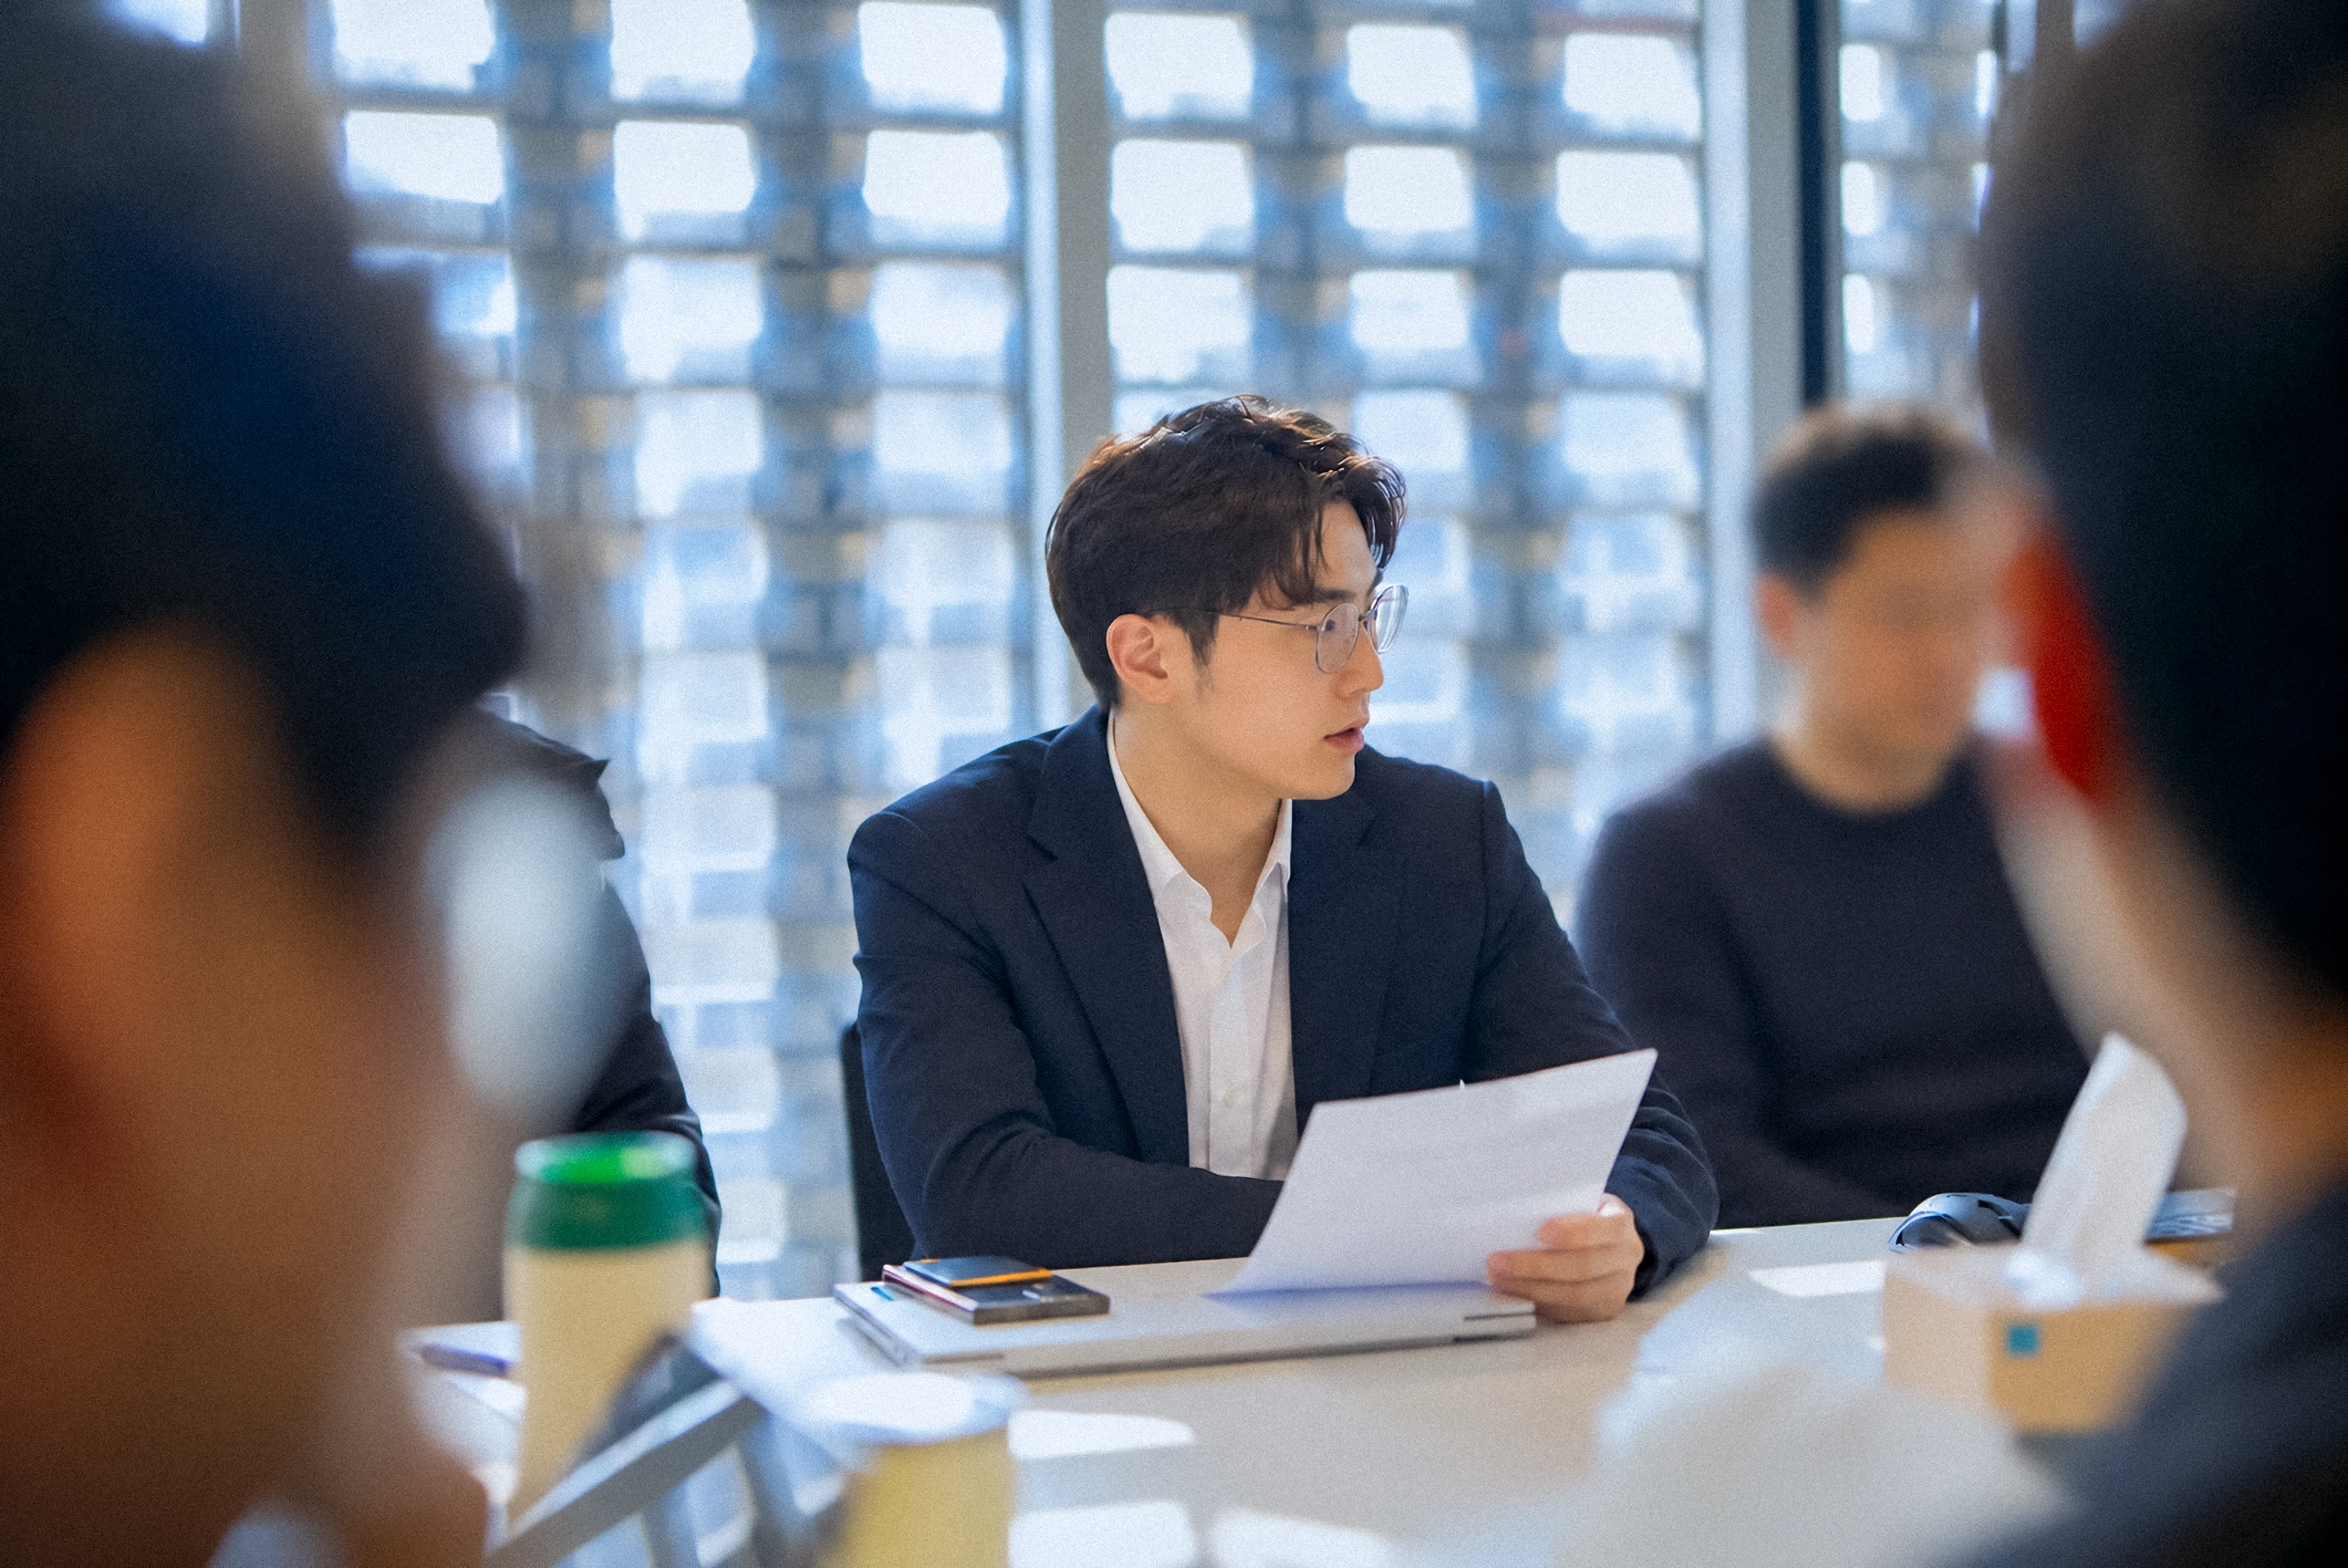
한국딥러닝이 2026년 11월 외부 투자 없는 흑자 성장과 누적 매출 100억 원 돌파까지 내린 다섯 가지 선택을 정리했다.
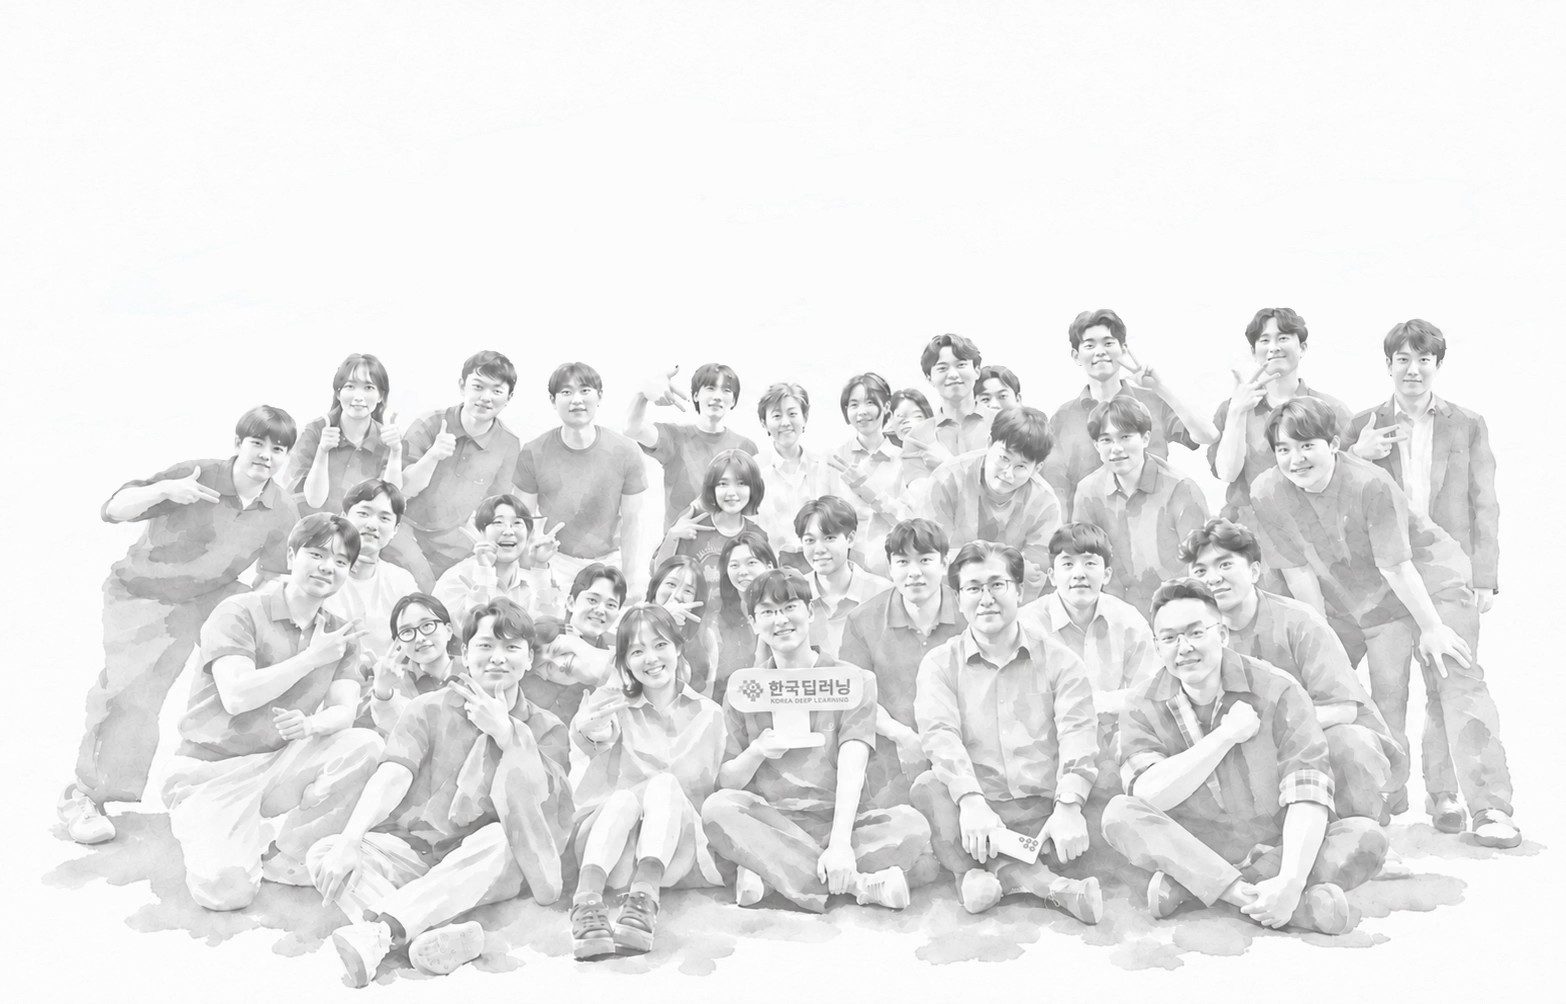
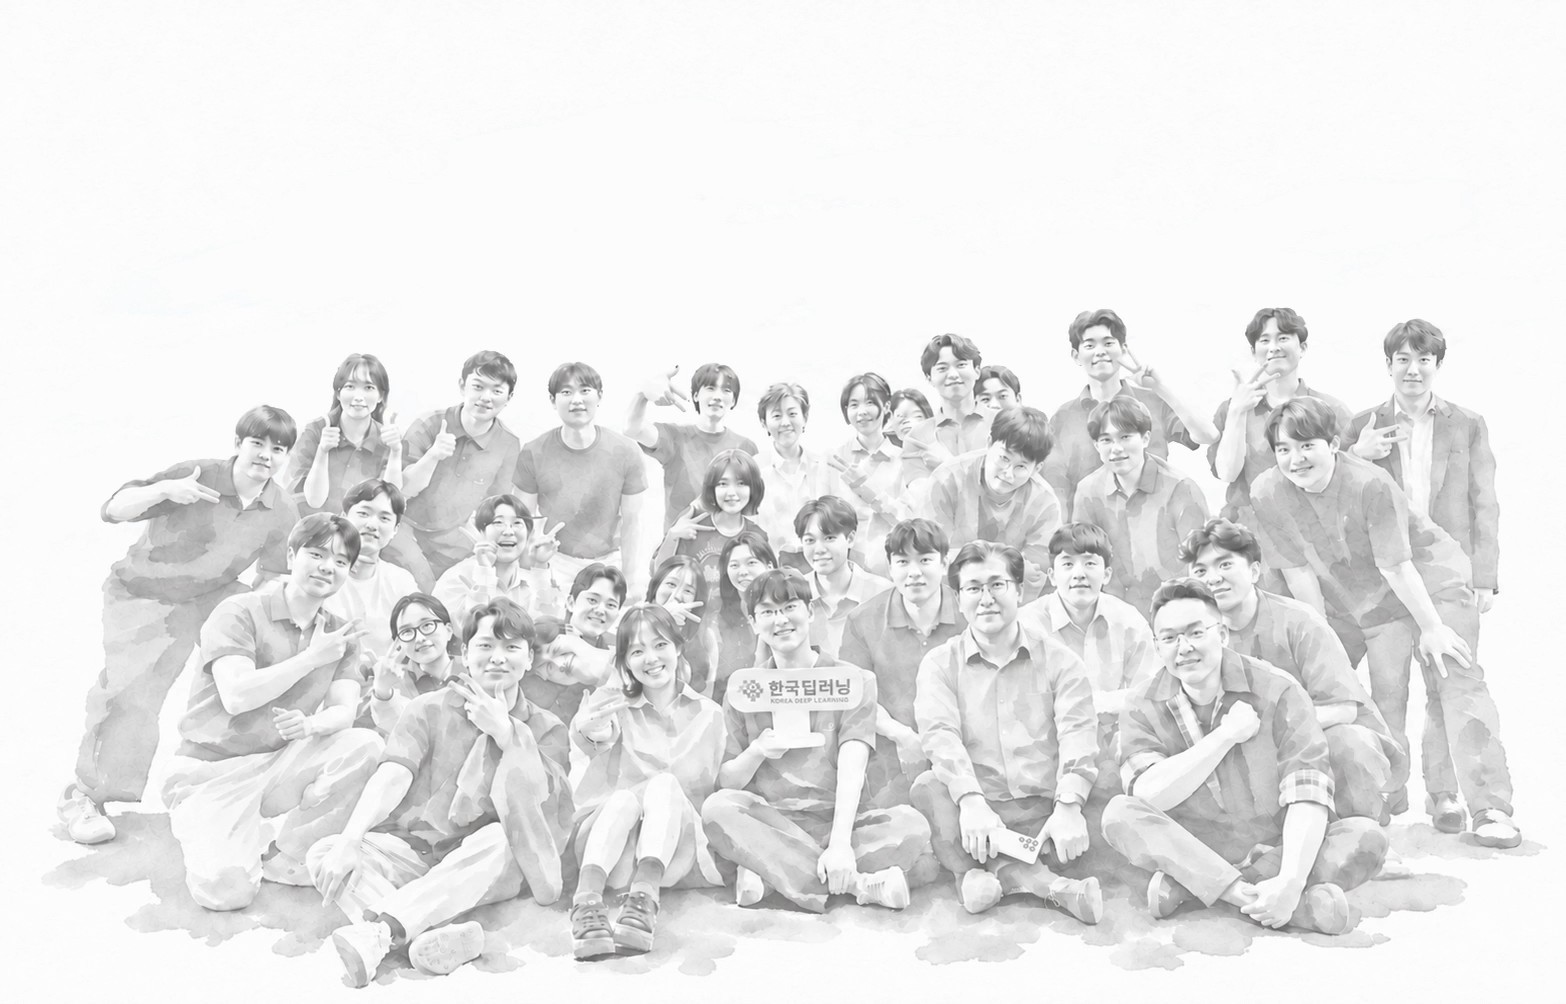
한국딥러닝은 2019년 설립 이후 6년 동안 기업의 문서 업무를 AI로 끝내는 일 하나를 파고들어, 지금은 문서를 읽고 처리하는 AI 에이전트를 만드는 회사가 됐다. 그사이 외부 투자 없이 흑자를 이어 가며 누적 매출 100억 원을 넘겼고, 80곳이 넘는 공공기관과 기업에 AI 솔루션을 공급했으며, 2026년에는 글로벌 AI 벤치마크에서 구글과 오픈AI를 제쳤다. '딥러닝'이라는 말이 아직 낯설던 때 시작한 회사가 여기까지 온 6년을, 한국딥러닝이 내린 다섯 가지 선택으로 돌아본다.
첫 번째 선택, 기업이 실제로 돈을 쓸 AI
한국딥러닝이 처음 따진 것은 유행이 아니었다. 기업이 실제로 돈을 쓸 AI가 무엇인지였다. 답은 문서였다. 문서를 쓰지 않는 조직은 없다. 그런데 현장에서는 기업이 이미 OCR을 쓰고 있는데도 사람이 결과를 다시 검수하고 입력하고 있었다. 한국딥러닝은 이 장면에서 출발했다.
글자만 읽는 OCR과 현장이 바라는 기술 사이에는 거리가 있었다. 값을 분류하고 맥락을 이해해야 비로소 일이 끝난다. 한국딥러닝은 문서를 읽고 처리하는 딥러닝이야말로 기업이 기꺼이 비용을 낼 기술이라고 판단했다. 딥러닝을 메타버스 같은 반짝 트렌드가 아니라 IT 업계의 방향을 바꿀 기술로 본 것이다. 사명을 한국딥러닝으로 지은 것도 같은 계산이었다. '딥러닝'이라는 키워드를 선점하고, 공공기관이 믿고 찾을 수 있는 직관적인 이름을 갖기 위해서였다. 덕분에 회사를 매번 설명할 필요가 없었다.
두 번째 선택, 5년 동안 투자를 받지 않는다
한국딥러닝은 창업 이듬해부터 흑자를 냈다. 팁스(TIPS) 지원금 1억 원 외에는 외부 자금 없이 5년을 자체 매출로만 성장했다. 그동안 연평균 400% 성장, 누적 매출 100억 원, 고객사 80곳이라는 숫자를 만들었다.
투자를 받지 않은 것은 재무 목표가 아니라 기술 전략이었다. 문서를 다루는 AI는 시간이 필요한 기술이고, 연구실 성적이 아니라 산업 현장에서 고객의 문제를 실제로 푸는 기술이어야 한다는 판단이었다. 자기 자본으로 가치를 만들지 못하는 회사가 외부 자금을 받는다고 유니콘이 될 수는 없다는 것이 한국딥러닝의 생각이었다. 자본의 크기보다, 고객이 돈을 낼 만큼 실제로 작동하는 기술을 먼저 만드는 쪽을 택했다.
그렇게 쌓인 것은 돈만이 아니었다. 한국딥러닝은 물류 인보이스, 금융 서류, 행정 문서처럼 산업마다 반복되는 양식을 프로젝트마다 모듈로 표준화했고, 6년이 지나자 수십 개의 모듈이 쌓였다. 필기체를 읽어야 하면 왜곡된 데이터를 인식하는 OCR 모듈을 붙이는 식이다. 이제는 고객 데이터를 보자마자 어떤 모듈을 켜야 할지 안다. 이 현장 레퍼런스가 곧 한국딥러닝의 속도와 비용 경쟁력이 됐다.
세 번째 선택, 노트북 한 대로 현장에서 증명한다
한국딥러닝 고객사의 절반 이상은 다른 OCR 도입에 실패한 뒤 찾아온 곳이다. 2년 가까이 씨름하다 기술적으로 처리가 불가능하다는 판정까지 받은 기업도 많았다. 한국딥러닝은 노트북 한 대만 들고 그 현장을 찾아가, 처리가 안 된다던 문서를 그 자리에서 읽어 보였다. 실무자들이 놀랄 정도였다.
한국딥러닝이 가장 자주 꺼내는 사례는 택배 현장이다. 운송장을 손으로 입력하느라 하루 10~11시간씩 일하던 택배 기사들의 업무를 AI로 자동화했고, 근무 만족도가 올라갔다. 한국딥러닝에게 AI는 사람의 시간을 찾아 주는 도구다. 그래서 성능의 기준도 벤치마크 점수가 아니다. 점수가 99점이냐 95점이냐보다, 실무자의 검수 시간을 얼마나 줄이느냐가 한국딥러닝이 보는 기준이다.
네 번째 선택, 박스를 그리지 않는 OCR
기술의 방향도 현장에서 나왔다. 기존 OCR은 문서의 특정 위치에 박스를 그려 학습시키는 방식에 갇혀 있었다. 기업마다 계약서와 세금계산서의 디자인이 다르니, 양식이 바뀔 때마다 다시 박스를 그려 학습하는 방식은 자동화라고 부르기 어렵다. 한국딥러닝은 디자인이 다른 문서도 추가 학습 없이 같은 성능을 내야 진짜 자동화라고 봤다.
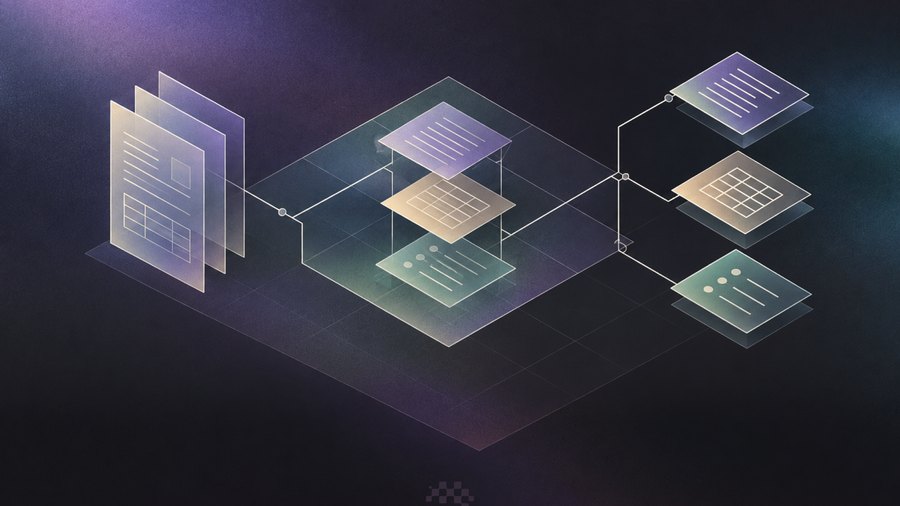
그 답으로 한국딥러닝은 4억 건이 넘는 문서를 학습한 자체 비전언어모델(VLM)을 만들고, 2025년 이를 상용화한 VLM OCR을 내놓았다. 고객사 데이터의 수집과 라벨링이 필요 없고, 맞춤 템플릿 없이 평균 2주 안팎에 배포하며, 미세조정 없이 핵심 필드를 추출한다는 '3 ZERO' 전략이 여기서 나왔다. 조직의 약 70%가 엔지니어이고, 프로젝트마다 석·박사급 전문가를 1대1 전담 매니저로 배정한다. 기술만 넘기는 회사가 아니라 고객사의 문제를 함께 푸는 실전형 파트너가 되겠다는 뜻이다. 사내에서 "'엔지니어틱'하게 생각하지 말자"는 표현을 일부러 쓰는 것도, 기술에 매몰되지 말고 시장과 고객을 보자는 같은 이유에서다.
다섯 번째 선택, 구조를 다진 뒤 외부 자본을 받는다
한국딥러닝은 2025년 10월 설립 후 처음으로 외부 자본을 받아들이기 시작했고, 2026년 1월 120억 원 규모의 시리즈A를 마무리했다. 내부 성장으로 구조를 먼저 다진 뒤 외부 자본을 택해야 한다는 원칙의 결과였다. 성장 전략도 기술 입소문에서 파트너 생태계로 옮겨 가고 있다.
2026년의 목표는 VLM OCR이 금융·물류·공공 주력 영역에서 성과를 증명하고, 국내에서 검증한 기술을 미국과 일본, 동남아로 넓히는 것이다. 한국 공공 문서의 난도가 매우 높은 만큼, 구조가 더 단순한 영어권과 동남아 문서에는 더 안정적으로 적용할 수 있다는 판단이다.
한국딥러닝이 그리는 끝 그림은 분명하다. 전자결재나 챗GPT가 처음 도입됐을 때처럼, 훗날 실무자들이 한국딥러닝 없이 예전엔 어떻게 일했느냐고 되묻게 되는 것이다. 사람들이 모르는 사이에 한국딥러닝의 에이전트가 세상의 문서를 읽고 업무 속도를 높이는 미래다.
한국딥러닝 소개
한국딥러닝(KDL)은 2019년 설립된 엔터프라이즈 AI 에이전트 기업이다. 자체 문서 특화 VLM 'KDL 프론티어'를 기반으로 기업과 공공기관의 문서 업무를 맡아 처리하는 AI Worker를 만든다. 주요 제품은 DEEP OCR, DEEP Parser, DEEP Agent, DEEP Ops다.
記事を共有
- 記事テキスト
- 記事メディア画像をダウンロード
出典
- 매일경제 2026-03-25
- EBN 2026-04-22
- EBN 2026-04-23
- 전자신문 2025-12-08
- 매일일보 2025-12-11
- 바이라인네트워크 2025-10-16
- 아주경제 2025-08-08
- 테크42 2025-07-11
- 시사저널e 2025-05-09
メディアお問い合わせ
韓国ディープラーニング