寄稿
公共データの91%、文書の構造化なしにはAIが読めない
韓国ディープラーニング公開
韓国ディープラーニングのキム・ジヒョン代表が、AIタイムズに「公共データの91%、文書の構造化なしにはAIが読めない」を寄稿しました。
電子化は終わっても、AIは読めない
寄稿は、政府がデジタルトランスフォーメーション(DX)から、行政の全過程にAIを取り入れる「行政トランスフォーメーション」へと進む途上にある隔たりを指摘しています。多くの行政機関が文書の電子化を終えたとしていますが、それは人が見るための電子文書のレベルです。PDFやHWP、画像の中で、AIは構造を理解できず、テキストだけを読み取ります。表は崩れ、数式は画像として処理され、手書きの記入や署名はデータになりません。筆者は、AIの視点から見ると、行政文書の90%以上が「データの死角」にあるとみています。
91.1%が非定型という現実
根拠として挙げたのは、ウィ・ソンゴン議員事務所による2025年10月の国政監査資料「公共分野のAI活用現況」です。公共機関が保有する文書の91.1%が、AIが活用しにくい非定型フォーマットで存在するという内容です。筆者はこれを、技術不足ではなく、文書がそもそもAIが解釈できる構造で設計されていないという問題だと解釈しています。
例も挙げています。ある省庁の事業計画書には、数十の表やグラフ、注釈、数式が含まれています。OCRは文字を抜き出せても、その表がどの政策項目や予算構造を説明しているのかまでは解釈できません。同じ言葉が、機関によって異なる意味を持つこともあります。「検討」は、ある機関では参考意見ですが、別の機関では決裁前の正式な手続きです。そのため、テキスト認識から一歩進んで、文書の構造と関係を把握する「意味単位の構造化」が必要だというのです。
「AIが読むためには、文書が『データの言語』に翻訳されなければなりません。」
— キム・ジヒョン 韓国ディープラーニング 代表
ボトルネックは技術ではなくデータの言語
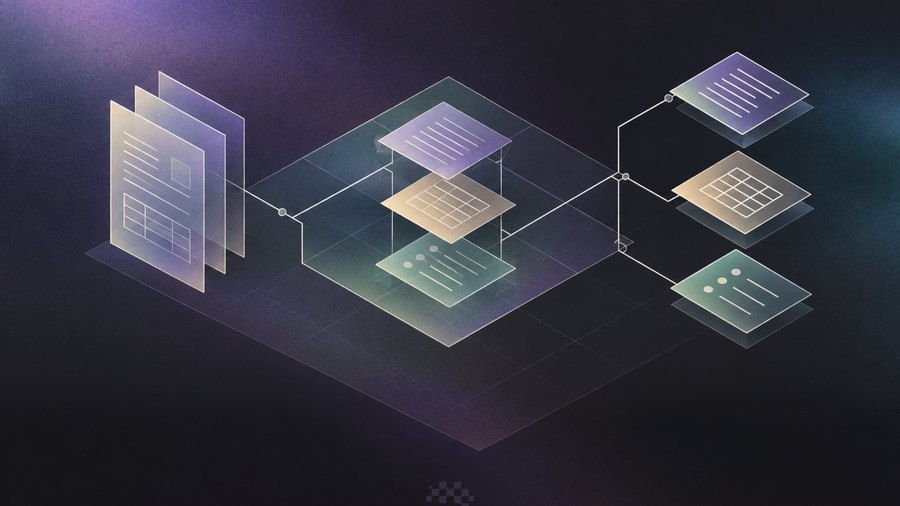
従来の行政データは人が読むように作成されてきましたが、AIは構造が明示的に表現されていなければ解釈できません。AIにとっては、改行や表の列の順序、項目の位置がすべて意味を持ちます。筆者が示す解決策は、文書の構造化です。パーシングによってレイアウトや項目間の関係、表の階層、段落の流れを分析し、AIが理解できる形に変えるプロセスです。韓国ディープラーニングのDEEP Agent+は、テキストや表、数式、図形、注釈、レイアウトを統合的に分析して文書の構造を復元し、非定型文書をデータベース化して、検索や要約、分類、統計分析に使えるようにします。
行政の効率化は構造化から始まる
結論は、AIを導入すれば行政がおのずと効率化するわけではないということです。スピードと精度はデータの準備度にかかっており、文書を電子ファイルに変えるだけでは、AIが読めるデータにはなりません。データは保管の対象ではなく、理解と判断の源泉にならなければならないという主張です。
「行政のボトルネックは、新しいシステムがないことではなく、AIが理解できる形でデータを準備していないことにあります。」
全文はAIタイムズに掲載されています。
韓国ディープラーニングについて
韓国ディープラーニング(KDL)は、2019年に設立されたエンタープライズAIエージェント企業です。自社開発の文書特化型VLM「KDL Frontier」を基盤に、企業や公共機関の文書業務を担って処理するAIエージェントを開発しています。主な製品はDEEP OCR、DEEP Parser、DEEP Agent、DEEP Opsです。