寄稿
製造AIセキュリティの核心、原文は理解しつつ、活用は統制せよ
韓国ディープラーニング公開
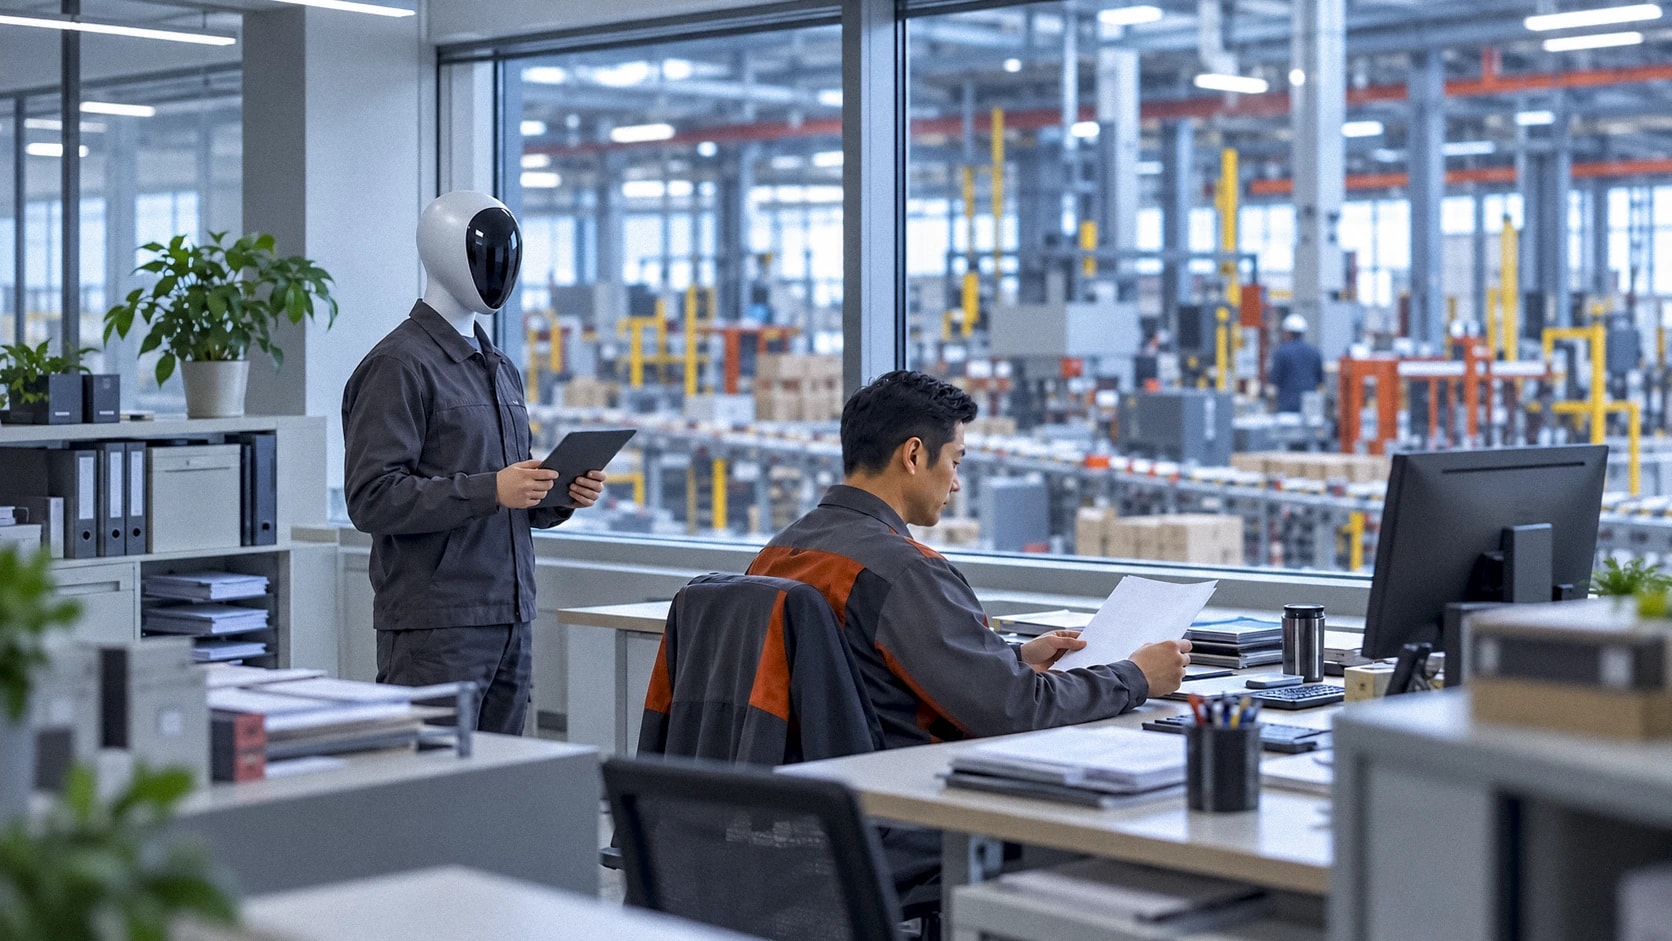
韓国ディープラーニングのキム・ドンヒョン未来AI開発チーム長が、AIタイムズに「製造AIセキュリティの核心:原文は理解しつつ、活用は統制せよ」を寄稿しました。製造文書をAIが読んだ瞬間、セキュリティはインフラの問題ではなく生産競争力の問題になるというのが、この文章の要旨です。
製造の現場では、問いが性能からセキュリティへと変わる
企業のAI導入をめぐる議論で最初に出る問いは、ほとんどが性能です。文書をどれだけ正確に読めるか、業務をどれだけ速く処理できるかが評価の基準になります。しかし製造の現場に入ると問いが変わると、筆者は指摘しました。この文書をAIが読んでもよいのか、読んだ結果はどこに保存されるのか、誰が見られるのか、協力会社や外部のシステムと共有できない文書はどれか、がまず問われます。
設計図面、BOM、作業標準書、工程条件表、品質検査表、不良分析レポート、設備点検日誌、協力会社の納品文書には、製品構造、部品構成、工程条件、検査基準、設備の状態、原価の流れ、協力会社の情報が含まれています。AIがこれらを要約し、漏れている項目を確認するのは有用ですが、その情報が権限のない協力会社に共有されたり、外部のモデルに送信されたり、ほかの業務に再利用されたりすれば、文書処理の問題ではなく「製造競争力の流出リスク」になります。
機微性は個人情報ではなく、工程と原価の流れにある
筆者は、製造文書の核心となるセキュリティの問題は、個人情報の保護とは性質が異なると説明しました。守るべきものは個人を識別する情報だけでなく、製品をつくる方法と原価の構造だというのです。どの部品がどの工程に使われるのか、どの協力会社が中核部品を供給しているのか、特定の設備でどんな不良が繰り返されているのかが蓄積されれば、製品戦略、工程の安定性、協力会社への依存度、原価改善の方向まで推定されかねません。設備点検の記録が露出すれば生産能力と稼働率が、BOMと納品情報が結びつけば原価構造と中核部品への依存度が明らかになるおそれがあります。
原文の理解は必要だが、原文の活用は統制されるべき
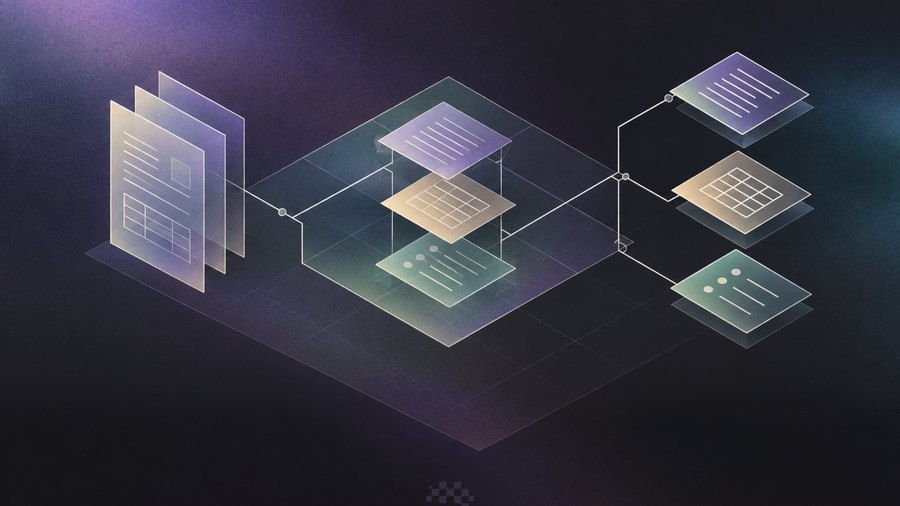
製造文書は、表、コード、図面、数値、注記、添付資料が絡み合っているため、一部のテキストだけを切り出しても正確に解釈するのは困難です。そのためAIは、原文の構造と項目間の関係を理解する必要があります。ただし筆者は、原文を理解することと、原文をそのまま活用することは別物だと強調しました。不良の原因を分類するには、検査項目、測定値、発生した工程、発生した時間を知る必要がありますが、その過程で製品全体のBOM、協力会社ごとの単価条件、中核となる工程レシピ、設備の配置情報があらゆる段階に露出する必要はありません。
「製造AIのセキュリティとは、原文へのアクセスを一律に遮断することではありません。文書の認識段階では原文の構造を理解しつつ、分析段階、共有段階、実行段階では、業務の目的に必要な情報だけが流れるように設計することです。」
読む権限と実行する権限を分ける
AIが品質検査表を読んで異常な項目に印を付けることと、その結果をもとに納品の差し戻しを確定したり生産ラインを止めたりすることは、異なるレベルの権限です。設備点検日誌を要約することと、それを協力会社に自動で共有することも同じです。筆者は、最も危険なのはAIが文書を読むことではなく、読んだ文書を根拠に、許可されていない行動にまで進んでしまうことだと指摘しました。
筆者は、韓国ディープラーニングのDEEP Agentが目指す文書特化型の業務自動化も、この点と通じていると説明しました。表、コード、項目名、図面、手書きの入力、検査の数値が混在する製造文書では、項目間の関係を理解する能力が重要であり、そこに機微度の分類、最小限の情報処理、閲覧と実行の権限の分離が組み合わさったとき、企業が信頼できる自動化の基盤になるというのです。
「セキュリティは、AI導入後の点検項目ではなく、製造自動化設計の出発点です。」
— キム・ドンヒョン 韓国ディープラーニング 未来AI開発チーム長
全文はAIタイムズに掲載されました。
韓国ディープラーニングについて
韓国ディープラーニング(KDL)は、2019年に設立されたエンタープライズAIエージェント企業です。自社開発の文書特化型VLM「KDL Frontier」を基盤に、企業や公共機関の文書業務を担って処理するAIエージェントを開発しています。主な製品はDEEP OCR、DEEP Parser、DEEP Agent、DEEP Opsです。