寄稿
生成AIの限界が明らかになったいま、企業は「文書AI」で現実的な自動化を選ぶ
韓国ディープラーニング公開
韓国ディープラーニングのキム・ジヒョン代表が、AIタイムズに「生成AIの限界が明らかになったいま、企業は文書AIで現実的な自動化を選ぶ」を寄稿しました。
生成AIが文書の前で止まってしまう理由
寄稿は、生成AIブームの後に企業が直面した現実から始まります。多くの企業が生成AIで文書業務を自動化しようとしていますが、すでに作成された文書の段落の流れや表の中の関係を、AIが正確に読み取れないという問題が明らかになっています。もっともらしい答えをつくり出す汎用の生成AIは、ハルシネーションやコスト、検証の問題から、中核業務にそのまま投入するのは困難です。
キム代表は、その原因を大規模言語モデルの仕組みに求めています。確率に基づくモデルは、情報が不完全だったり文書の構造が崩れていたりすると、空白を推論で埋めてしまい、それがハルシネーションにつながるというのです。
「結局、問題の核心はモデルの規模や性能ではなく、AIが何を読んでいるのかにあります。」
— キム・ジヒョン 韓国ディープラーニング 代表
必要なのは文書の構造化
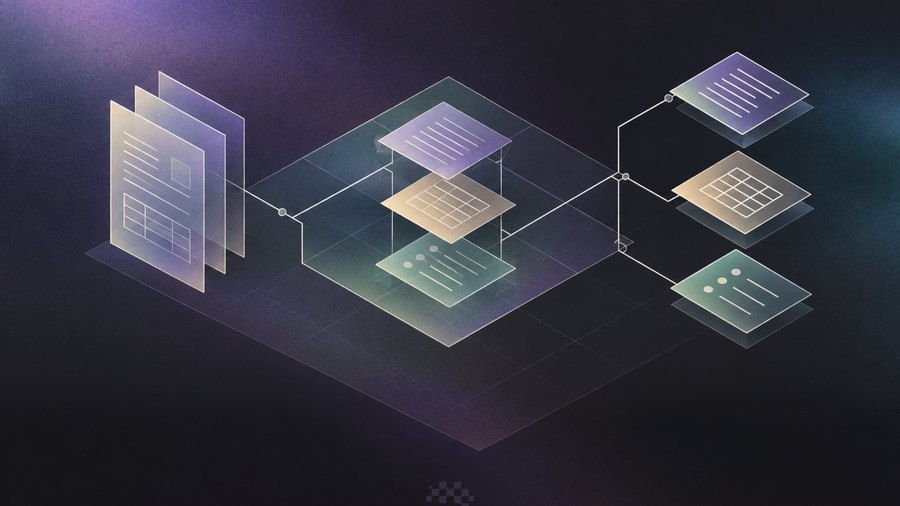
解決策は、文書を新たに書き直すことではありません。キム代表は、担当者が間違った文書をつくっているのではなく、AIが文書を人のように読めないだけだと指摘します。まず必要なのは、既存の文書の構造と項目どうしの関係を復元する文書の構造化だということです。文書をきちんと読めなければ自動化には至らず、人がAIの結果を改めて検証しなければならないという逆説が生まれます。
この点で、文書AIは入力と出力が明確で効果を測定できるため、投資対効果が最もはっきりした自動化の領域だというのが寄稿の主張です。金融、公共、医療のようにセキュリティが重要な機関には、文書を外部に出さないオンプレミスでの構造化が欠かせないことも指摘しました。
文書はAIの判断の基本データ
寄稿は、文書はもはや保管用のファイルではなく、AIの判断の基本データになったと結論づけています。企業のAIの正確さは、文書を読む力から始まるということです。
「きちんと読めなければ、きちんと判断することはできません。AIの誤りは、そのまま企業の誤りになるからです。」
全文はAIタイムズに掲載されました。
韓国ディープラーニングについて
韓国ディープラーニング(KDL)は、2019年に設立されたエンタープライズAIエージェント企業です。自社開発の文書特化型VLM「KDL Frontier」を基盤に、企業や公共機関の文書業務を担って処理するAIエージェントを開発しています。主な製品はDEEP OCR、DEEP Parser、DEEP Agent、DEEP Opsです。