技術と構成
LLM OCRとは何か: 大規模言語モデルで文書を読むときに知っておくべき仕組みと限界の完全ガイド
KDL作成
LLM OCRとは、大規模言語モデルがOCRで読み取られたテキストや文書画像を受け取り、文脈を根拠に文字を判読または補正し、必要な項目を決まった形式に整理して出力する文書認識の方式です。
LLM OCRが注目される理由
書式ごとにルールを作らなくてよいからです。
従来のOCRベースの文書処理では、文字を読んだ後にどの値がどの項目に当たるのかを見つけるため、書式ごとに位置のルールやテンプレートを作る必要がありました。発行元がレイアウトをわずかに変えただけでもルールを直す必要があり、初めて見る書式は人が手で入力するしかありませんでした。
大規模言語モデルは文脈を理解するため、「契約金額と契約期間を探してください」という指示だけで、初めて見る書式からでも項目を見つけられます。かすれた文字や略語も、前後の文を根拠に正せます。
この利便性から、文書認識に大規模言語モデルを組み合わせる試みが急速に増えています。ただし大規模言語モデルは、画像の文字を書き写すモデルではなく、もっともらしい文章を生成するモデルです。業務で使う前に、この性質が結果にどう現れるかを検討する必要があります。
LLM OCRの正確な定義: OCRとどう違うのか
OCRとLLM OCR、3つの軸での違い
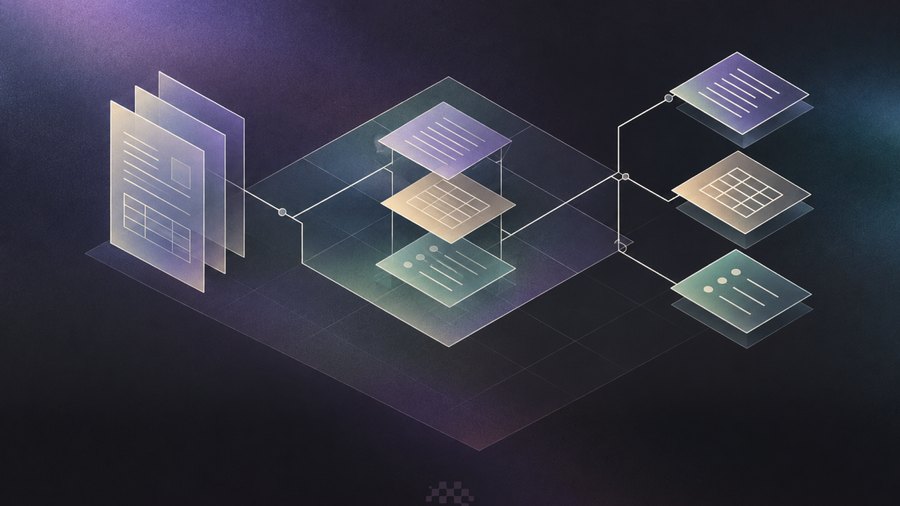
LLM OCRには2つの形があります。1つは、OCRエンジンが読み取ったテキストを大規模言語モデルが受け取り、補正して整理する方式です。もう1つは、画像を入力として受け取るモデルが文書を直接読み、結果を出力する方式です。画像を直接読むモデルは技術分類ではVLMに属しますが、結果を言語モデルが生成するという点は同じです。
第一に、結果の作り方が違います。OCRは画像の中にある文字を見つけ、そのまま書き写します。LLM OCRは入力を根拠にもっともらしい文章を生成するため、原本にない値が自然な形で混ざることがあります。
第二に、位置情報が違います。OCRは文字ごとに文書内の座標を返すため、結果が原本のどこから来たのかをすぐに確認できます。LLM OCRはテキストだけを返すことが多く、値の出所をたどりにくくなります。
第三に、文脈の使い方が違います。OCRは文字単位で判断するため、前後の文はほとんど判読に影響しません。LLM OCRは文脈を積極的に使ってかすれた文字を補正し、項目の意味を解釈しますが、同じ性質のために読めない部分を推測で埋めることもあります。
まとめると、OCRは確認できる判読に強く、LLM OCRは解釈と整理に強いといえます。業務では、どちらか一方を選ぶよりも役割を分けて併用する構成が多く見られます。
業務でLLM OCRを使うための5つの条件
実運用で求められるLLM OCRの5つの条件
第一に、結果ごとに根拠の位置を確認できることです。抽出した値が原画像のどの領域から来たのかが結び付いていれば、確認者はすばやく照合できます。
第二に、読み取れなかった値は空欄にすることです。判読に自信のない項目を推測で埋めず、空欄や確認要として表示するように、指示文と出力形式を設計します。
第三に、出力形式が固定されていることです。項目名、データ型、日付と金額の表記ルールを抽出スキーマで定めておけば、後続のシステムが結果をそのまま受け取れます。
第四に、性質の異なる方式で相互検証することです。座標を返すOCR結果や、合計のような計算ルールと比較し、互いに食い違う値を見つけ出します。
第五に、運用環境に合わせて導入できることです。個人情報を含む文書を外部のモデルに送りにくい組織では、まず社内に設置して使えるかどうかを確認します。
LLM OCRの実際の適用方法
判読と解釈を分けて配置します
文字や数字を正確に書き写す必要がある区間は、座標を返す認識モデルに任せます。大規模言語モデルは、読み取られたテキストを解釈して項目を探し、形式を整える区間に置きます。金額や口座番号のように、1文字間違えても事故になる項目は、生成された結果をそのまま使わず、判読結果と照合します。
抽出基準に例外ルールもあわせて書きます
指示文には、探す項目だけでなく、値がない場合や読めない場合の扱いも書いておきます。たとえば署名欄が空であれば空の値とする、金額が2か所で異なって書かれていればどちらも返す、といった定め方です。例外ルールがないと、モデルは空欄をもっともらしい値で埋めようとします。
実際の文書で前後を比較して検証します
導入前に、実際の業務文書と正解データを集め、項目ごとの精度を測定します。文字単位の一致とは別に、原本にない値が出た件数を数えてください。それがLLM OCRの本当のリスクを示します。モデルや指示文を変えるたびに、同じ文書で測り直します。
韓国環境でのLLM OCR
韓国の金融や公共の文書には、住民登録番号や口座番号などの個人情報が多く含まれます。ネットワーク分離の規定により、外部のモデルAPIを使いにくい場合も少なくありません。そのため、社内に設置したモデルで判読と解釈の両方を処理する構成が一般的です。
手書きの文字、印鑑、漢字が混ざった古い書式、FAXで受け取った低解像度の文書など、韓国の文書によく現れる形式は、個別に性能を確認する必要があります。英語の文書で汎用モデルが示した性能が、韓国語の業務文書でもそのまま出るとは限りません。
よくある質問
LLM OCRとVLMは同じものですか?
一部が重なっています。VLMは画像と言語を一緒に処理するモデルの種類を指し、LLM OCRは言語モデルが文書認識の結果を作り出す方式を指します。画像を直接読むLLM OCRの多くはVLMを使います。
LLM OCRは既存のOCRを置き換えますか?
置き換えというより役割分担に近いものです。座標とともに正確な判読が必要な区間にはOCRを使い、解釈と整理が必要な区間には大規模言語モデルを使います。
ハルシネーションはどのように防ぎますか?
読み取れない値は空欄にするよう指示し、結果を原本の位置と結び付けて確認し、性質の異なる判読結果と相互検証します。ただし、モデル1つの性能だけで完全に防ぐことはできません。
初めて見る書式も処理できますか?
テンプレートなしで項目を探せることがLLM OCRの強みです。ただし、初めて見る書式ほど人による確認の割合を高くして始めるほうが安全です。
手書き文字も読めますか?
読めますが、精度はモデルと文字の状態によって大きく変わります。韓国語の手書きが多い業務では、まず実際の文書で測定してください。
外部APIを使ってもよいですか?
文書に個人情報や営業秘密が含まれていなければ使えます。金融や公共のように規制がある分野では、まず社内設置型の構成を検討してください。
結果をそのまま業務システムに入れてもよいですか?
形式の検証と相互検証を通過した値だけを自動で入れ、基準を満たさない値は人が確認するように、流れを分けるのがよいでしょう。
処理したい文書のサンプルと抽出項目をお知らせいただければ、LLM OCRを適用する区間と、判読結果で検証すべき区間に分けて整理してお伝えします。
お問い合わせ