データと品質
AIレディデータとは: AIがすぐに読んで使えるように整えられたデータの完全ガイド
KDL作成
AIレディデータとは、文書や記録を、AIが検索し、判断し、処理するためにすぐ使えるよう、構造、出典、品質、利用条件を整えて整理したデータのことで、生成AIとAIエージェントを業務で使うための出発点になります。
AIレディデータが必要な理由
ファイルがあるからといって、使えるわけではありませんでした。
多くの組織では、すでに文書を電子化しています。紙の書類はスキャンしたファイルになり、報告書や規程はワープロのファイルやPDFとして蓄積されています。しかし、生成AIを接続してみると、望む答えが出ないことがよくあります。表が文字の塊につぶれてしまい、どの文書の何ページから出た内容かがわからず、廃止された規程と現行の規程が混ざって検索されてしまいます。
問題は、AIモデルよりもデータの側にある場合が多いです。人が開いて読めるファイルと、AIが正確に探し出して使えるデータとの間には、違いがあります。この違いを埋めないままモデルだけを変えても、結果はあまり変わりません。
AIエージェントが文書を根拠に実際の業務を処理する段階へ進むと、求められる水準はさらに高くなります。判断の根拠になった原文の位置を示せる必要があり、閲覧権限のない人に機密情報が見えないようにする必要があります。
AIレディデータの正確な定義: 電子化されたデータとの違い
電子化されたデータとAIレディデータの3つの軸の違い
第一に、構造が異なります。電子化されたデータは、紙をファイルに移しただけの状態なので、タイトル、本文、表、脚注の区別が残っていないことがよくあります。AIレディデータは、見出しの階層、表の行と列、画像の説明を生かし、機械が構造を認識できる形に変換されています。
第二に、文脈の情報が異なります。電子化されたデータには、ファイル名程度しか残らないことが多いです。AIレディデータは、文書の種類、作成日、適用期間、元のファイルとページ番号などのメタデータを、内容の断片ごとに結び付けています。そのため、検索の範囲を絞り込み、根拠をたどり直せます。
第三に、管理の状態が異なります。電子化されたデータは、保存したあとに品質を別途確認しないことが多いです。AIレディデータは、変換が正しく行われたことを確認し、個人情報をマスキングし、誰が閲覧できるかを定めた状態にあります。
電子化は、AIレディデータへの第一段階です。スキャンと電子化が終わっていれば、その結果を構造化し、検証する段階が残っていると考えてください。
AIレディデータの5つの条件
AIがすぐに使えるデータが備えるべき5つの条件
第一に、構造が保たれていることです。表は表のまま、リストはリストのまま残っていて、セルの値どうしの関係が崩れていない必要があります。
第二に、メタデータが付いていることです。文書の種類、日付、部署のように、検索を絞り込む基準となる情報が必要です。
第三に、出典とつながっていることです。内容の断片ごとに、元のファイルとページ、位置が残っていれば、AIの回答を人が確認できます。
第四に、品質が確認されていることです。認識の誤りや欠落がないかを、サンプルで点検した記録が必要です。
第五に、権限と非識別化が反映されていることです。機密情報はマスキングされ、閲覧の権限がデータと一緒に管理されている必要があります。
5つの条件をいっせいにすべて満たすのではなく、利用の目的に応じて優先順位を決めます。社内検索が目的なら、構造とメタデータが先です。外部のサービスで使うなら、権限と非識別化を先に確認します。
AIレディデータを作る実際の方法
使い道を先に決めて、範囲を絞ります
保有しているすべての文書を一度に整理しようとすると、終わりません。規程に関する質疑応答、契約書の確認、苦情対応など、まず適用する業務を決め、その業務に必要な文書群から整理します。
業務が決まると、必要なメタデータや求められる品質の水準も決まります。実際の質問の一覧をあらかじめ集めておけば、整理したデータで答えが出るかをすぐに評価できます。
元の文書から構造を生かして変換します
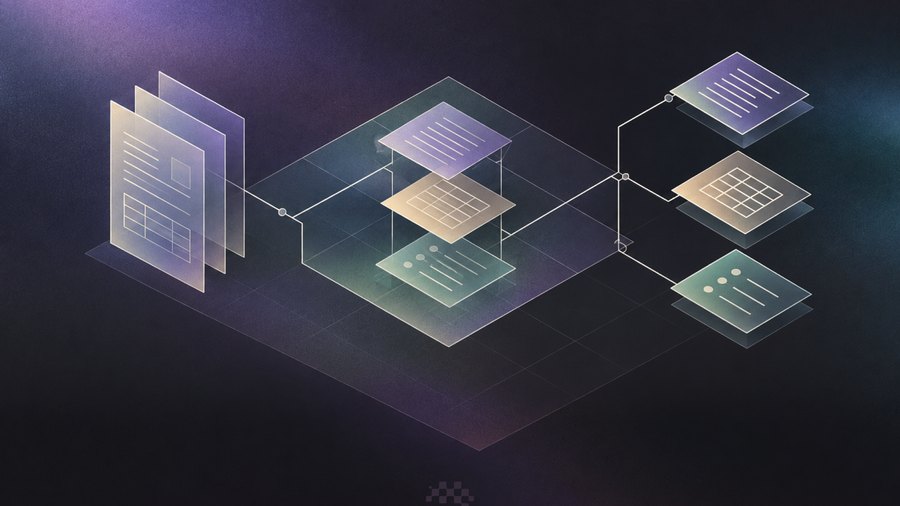
スキャンした画像、PDF、HWP形式のファイルを解析し、テキスト、表、画像、ページ情報を分けて抽出します。抽出した結果は、JSONやMarkdownのように後続のシステムが読みやすい形式で保存し、検索に使う場合は意味の単位でチャンクに分けます。
公共分野の生成AIプラットフォームを構築した事例では、テキスト、表、画像、ページ情報、チャンク、キーワードを抽出し、非識別化まで行ってDBに登録できる構造化データにすることを、前処理の範囲としました。
登録する前に品質と権限を確認します
変換の結果を原本と照合し、表の構造が崩れていないか、抜けているページがないかをサンプルで確認します。個人情報は登録する前にマスキングし、文書ごとの閲覧権限を、検索の段階にもそのまま適用されるように結び付けます。原本が改訂されたら、データも一緒に更新されるようバージョンを管理します。
登録したあとに問題が見つかると、そのデータから作られた回答や処理の結果まで遡って確認しなければならないため、確認は登録の前に行うほうがコストが小さくなります。
国内環境でのAIレディデータ
国内の公共機関や企業には、HWP形式の文書が多くあります。そのため、そのファイルを構造を保ったまま読めるかが最初の関門になります。決裁欄や印鑑、複雑に結合された表も多く、海外のツールでは構造が崩れやすいです。
金融と公共では、原本の文書を外部に出すことが難しいため、変換と非識別化を社内の環境で処理できる必要があります。ネットワーク分離の環境であれば、変換ツールと保管場所を同じ社内ネットワーク内に置く構成を、まず検討します。
よくある質問
すでに電子化した文書も、作業し直す必要がありますか?
ファイルを作り直す必要はありません。既存のファイルを解析して、構造とメタデータを付ける作業が追加で必要になります。
AIレディデータとRAG前処理は同じものですか?
RAG前処理は、検索を基盤とする生成AIに合わせた準備の作業です。AIレディデータは、検索だけでなく、抽出や自動化にも使えるデータの状態を指します。
テキストだけを抽出すれば十分ですか?
表と文書の構造が失われると、数値と項目の関係をAIが誤って読みやすくなります。規程や報告書のように表が多い文書ほど、構造の保持が重要です。
どの程度の品質があれば十分ですか?
活用する業務によって異なります。金額や条項を引用する業務であれば、サンプル点検の基準を高く設定します。参考程度の検索であれば、まずは範囲を広げることを優先する場合もあります。
個人情報が含まれる文書はどうすればよいですか?
登録する前に非識別化し、原本は権限のある人だけが見られるように分けておきます。検索結果にも権限が適用されているかを確認します。
一度作れば、ずっと使い続けられますか?
文書は改訂され、新しい文書も次々に作られます。新しい文書が入ってきたときに同じ手順で変換されるパイプラインを作っておかないと、データが古くなってしまいます。
どこから始めるのがよいですか?
質問が最も多く寄せられる文書群や、探すのに最も時間がかかる文書群から始めると、効果を確認しやすくなります。
AIにつなぎたい文書の種類と形式をお知らせください。AIレディデータにするための変換の範囲と確認項目を整理してお伝えします。
お問い合わせ