Story
한국딥러닝 DEEP OCR, 수기 운송장에서 은행 팩스 서류까지 사람의 시간을 돌려줬다
한국딥러닝이 2026년 11월 수기 운송장 전산화부터 IBK기업은행 서류 처리시간 88% 단축까지 AI로 현장의 시간을 돌려준 과정을 되짚었다.
택배 분류 라인 위로 상자가 흘러간다. 스캐너가 운송장 바코드를 읽으면 상자는 제 갈 길로 빠지고, 읽지 못하면 자동 분류 라인에서 밀려난다. 그렇게 빠진 상자는 미분류물이 되고, 누군가 운송장을 들여다보며 하나하나 다시 확인해야 한다. 한국딥러닝에 따르면 이런 미분류물은 하루 평균 최소 2만 건, 많게는 40만 건에 이른다. 손으로 쓴 운송장은 사정이 더 어렵다. 글씨체와 기재 방식이 제각각이라 처음부터 사람이 읽고 분류해야 하는 경우가 많다.
4년 뒤, 한국딥러닝이 들여다보는 종이는 은행 안쪽으로 들어온 팩스 서류다. 보이스피싱 피해자가 보낸 피해구제신청서와 신분증이다. 신청서에는 손글씨가 섞여 있고, 팩스를 거친 신분증은 해상도가 낮다. 운송장과 피해구제신청서는 서로 다른 세계의 문서지만, 두 장면에는 같은 문제가 있었다. 사람이 종이를 읽고 옮겨 적는 데 너무 많은 시간을 쓰고 있었다는 것이다. 택배 현장에서 은행 내부망까지, 한국딥러닝의 AI가 지나온 자리를 그곳의 사람들을 따라 되짚어 본다.
운송장을 손으로 입력하던 하루
2022년 봄, 한국딥러닝은 두 개의 소식을 함께 전했다. 하나는 '2022 대한민국 임팩테크 대상'에서 받은 한국경제신문 사장상이다. 수상 기술은 DEEP OCR을 적용한 '딥러닝 기반 운송정보 이중인식 시스템'이었다. 바코드 오인식이 발생하면 즉시 운송장의 주소를 다시 인식해, 라인 밖으로 밀려날 상자를 줄이는 방식이다. CNN(YOLO) 알고리즘 기반의 딥러닝 OCR 기술을 썼다.
다른 하나는 성화기업택배와 함께 정보통신산업진흥원의 '2022년 AI 바우처 지원사업'에 최종 선정됐다는 소식이었다. 선정은 4월 4일 확정됐고, 과제명은 '수기 운송장 전산화를 위한 초고속 딥러닝 운송장 인식 시스템'이었다. 성화기업택배는 전국 70여 개 물류 네트워크를 갖춘 기업택배 회사로, 10만 건 이상의 수기 운송장 데이터를 보유하고 있었다. 현장의 운송장 데이터와 한국딥러닝의 DEEP OCR을 한 컨소시엄 안에서 결합해, 손으로 쓴 운송장을 배송 정보 데이터로 바꾸고 물류 분류를 자동화하는 것이 목표였다.
당시 한국딥러닝이 내세운 목표는 분류 속도에서 끝나지 않았다. 택배기사의 업무 피로도와 과로 문제를 함께 꺼냈다. 몇 해 뒤 EBN 인터뷰에서 한국딥러닝이 꼽은 사례도 택배 현장이었다. 운송장을 손으로 입력하느라 하루 10~11시간씩 일하던 택배 기사들의 업무를 AI로 자동화했고, 이후 근무 만족도가 높아졌다는 이야기다.
"솔루션 도입 후 업무 시간이 단축돼 근무 만족도가 높아졌다는 현장의 목소리를 들을 때 가장 큰 보람을 느낍니다."
— 김지현 한국딥러닝 대표
우편물 위에 적힌 주소
택배와 함께 한국딥러닝이 다뤄 온 또 하나의 물류 문서는 우편물이다. 회사는 우체국 초고속 물류 OCR과 수기 운송장 전산화 사업을 거치며 물류 문서를 읽는 경험을 쌓았다.
2024년 9월, 한국딥러닝은 한국데이터산업진흥원이 전담하는 데이터바우처 지원사업으로 우편물 주소판독 OCR 시스템 개발에 참여하고 있다고 밝혔다. 수요기업은 엔에프씨앤티였고, 한국딥러닝은 공급기업으로 참여했다. 출발점은 작업자의 손이었다. 등기 우편물과 비정형 우편물은 작업자가 수작업으로 분류하고 있었다.
시스템은 우편물 표면에 적힌 도착지 주소를 딥러닝 OCR이 자동으로 판독하고, 판독한 주소로 분류 정보를 만들어 후속 물류 처리로 넘긴다. 사람이 주소를 읽고 구분하던 단계를 AI가 맡으면 분류 속도가 빨라지고, 작업자마다 판단이 달라 생기는 오분류도 줄일 수 있다. 사람이 눈으로 읽던 글자를 기계가 대신 읽는다는 점에서, 운송장과 같은 질문이었다.
노트북 한 대로 증명하는 방식
현장을 찾아가는 한국딥러닝의 방식은 단출하다. 한국딥러닝에 따르면 고객사의 절반 이상은 다른 OCR 도입에 실패한 뒤 한국딥러닝을 찾았다. 2년 가까이 씨름하다가 기술적으로 처리가 불가능하다는 판정까지 받은 기업도 많았다.
한국딥러닝이 현장에 노트북 한 대만 들고 찾아가 처리가 안 된다는 문서를 즉석에서 바로 해독해 보이면, 실무자들이 놀랄 정도라는 것이 한국딥러닝의 설명이다.
그 자리에서 문서를 읽어 낼 수 있는 이유는 기술의 방향에 있다. 한국딥러닝은 기존 OCR을 문서의 특정 위치에 박스를 그려 학습시키는 방식에 갇힌 기술로 진단했다. 기업마다 계약서와 세금계산서, 신청서의 디자인이 다르기 때문에, 양식이 바뀔 때마다 다시 박스를 그려야 하는 방식으로는 실제 업무에 쓰기 어렵다. 한국딥러닝의 DEEP OCR+는 별도의 라벨링이나 재학습 없이 문서를 바로 처리한다. 4억 장 이상의 독자 데이터셋으로 학습한 자체 모델이 그 바탕이다.
현장에서 확인한 숫자도 있다. 한 공공기관에서는 신청 서류 약 50건을 손으로 입력하던 시간이 1시간에서 3분으로 줄었다. 그래도 한국딥러닝은 기술만으로 도입이 끝난다고 보지 않는다. 보안이 중요한 곳에는 온프레미스(폐쇄망)로 구축하고, 석박사급 기술 PM을 고객사에 1대1로 배치하는 'AI PMO' 서비스를 함께 운영하는 이유다.
한국딥러닝은 기술만 제공한다고 자동화가 완성되지는 않으며, 각 현장의 제약을 정확히 진단해 적용 가능한 구조를 설계하는 것이 진짜 도입 성공의 열쇠라고 강조한다.
팩스로 들어온 피해구제 서류
2026년, 그 방식은 은행으로 향했다. 보이스피싱 피해구제는 피해자가 신청서와 신분증을 팩스로 접수하면, 은행 직원이 서류를 하나하나 확인하고 필요한 정보를 시스템에 직접 입력하는 방식으로 처리돼 왔다. 피해금 동결과 구제는 속도가 핵심이지만, 서류 확인과 입력에만 많은 시간이 들어 골든타임 안에 대응하기 어려웠다. 팩스로 들어온 신분증은 해상도가 낮아 기존 AI-OCR로는 정확히 읽기 어려웠고, 접수된 서류가 어떤 문서인지 구분하는 일부터 사람이 맡아야 했다.
"보이스피싱 피해구제에서 가장 아까운 시간은 피해 대응에 쓰지 못하고 서류 처리에 소모되는 시간입니다."
— 김지현 한국딥러닝 대표
실증은 IBK기업은행 금융소비자지원부 주도로 4월부터 8월까지 진행됐다. 한국딥러닝은 VLM 엔진 고도화, 문서 처리 파이프라인, 검수 대시보드 구축, 성능 검증, 은행 내부망 배포를 맡았다. 양사는 금융 특화 AI 에이전트 'DEEP Agent for 금융'으로 시스템을 구축했다. 시스템은 접수된 서류의 종류를 구분하고 핵심 데이터를 추출한 뒤, 서류 내용을 분석해 범죄 유형까지 추론한다.
여기서도 사람의 자리는 남겨 두었다. AI-OCR과 VLM의 결과를 서로 교차 검증해 신뢰도가 높은 서류는 자동으로 처리하고, 신뢰도가 낮은 서류는 담당자 검수로 넘긴다. AI는 정보 처리와 판단을 보조하고, 최종 판단은 은행 직원이 내린다. 시스템은 은행 내부망에 온프레미스로 구축돼 금융 정보가 외부 클라우드로 나가지 않는다.
결과는 서류 처리시간 88% 단축이었다. 인쇄체 인식 정확도는 100%, 필기체 인식 정확도는 97% 이상을 기록했고, 문서 분류와 범죄 유형 추론은 평가 기준 100%의 정확도를 보였다. 이 과제는 '2026 공공기관 AI혁신 챌린지' AI 서비스 실증(PoC) 부문에서 우수상을 받았고, IBK기업은행은 장관상을 수상했다. IBK기업은행 금융소비자지원부 관계자는 이번 실증으로 피해구제에 필요한 대응 시간을 확보하고 금융소비자 보호를 강화할 가능성을 확인했다고 말했다. IBK기업은행은 2027년 상반기 실제 피해구제 업무에 이 기술을 적용할 계획이다.
사람에게 시간을 돌려준다는 것
한국딥러닝은 AI를 '사람의 시간을 찾아주는 도구'로 정의한다. 그래서 한국딥러닝이 보는 성능의 기준은 벤치마크 점수가 아니다. 점수가 99점이냐 95점이냐보다, 실무자의 검수 시간을 얼마나 줄여 주느냐가 중요하다는 것이다. 문서 특화 VLM으로 환각을 억제하려는 이유도 같다.
그 기준은 숫자로도 남았다. 국내 대형 캐피탈사 PoC 시뮬레이션에서는 대출 서류를 사람이 직접 입력하던 시간이 월 3만 시간에서 약 1,000시간으로, 약 96% 줄었다. 업무 처리 시간을 96% 줄이고 휴먼 에러를 1518%에서 34% 수준으로 낮춘 사례도 있다. 반복 입력에서 풀려난 실무자는 예외 건의 검수와 판단에 집중할 수 있다.
현장마다 돌려받은 시간의 모양은 달랐다. 택배 기사에게는 운송장을 입력하던 하루 10~11시간이었고, 우편물 분류 현장의 작업자에게는 주소를 읽고 나누던 손의 시간이었다. 은행 직원에게는 피해자를 위해 써야 할 골든타임이었다. 한국딥러닝은 전자결재나 챗GPT가 처음 도입됐을 때처럼, 훗날 실무자들이 한국딥러닝 솔루션 없이 예전엔 어떻게 일했느냐고 되묻게 되는 기술을 만들고 싶어 한다. 종이를 읽는 일이 조용히 기계로 넘어가는 동안, 사람은 사람이 해야 할 일로 돌아간다.
DEEP OCR에 관해
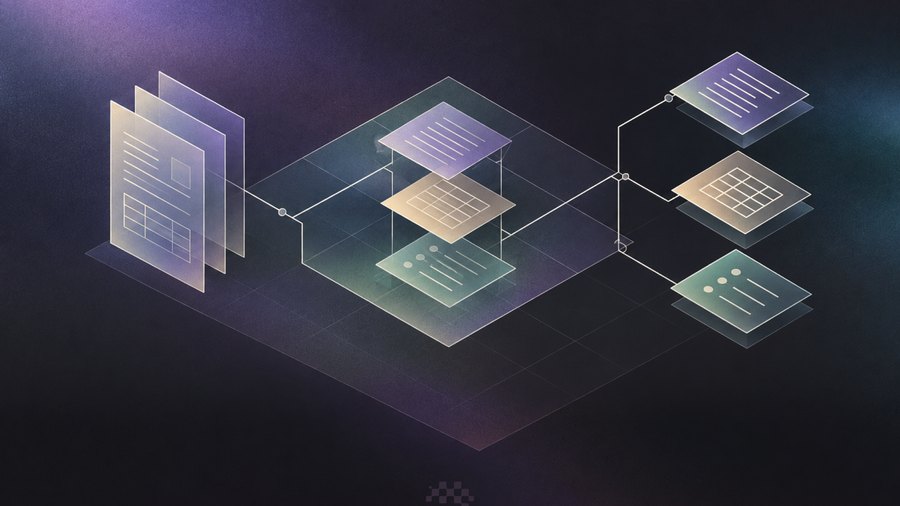
한국딥러닝은 문서를 읽는 일에서 출발했다. DEEP OCR은 자체 문서 특화 VLM을 기반으로 글자만이 아니라 문서의 구조와 의미를 함께 읽는 국내 최초의 VLM 기반 OCR 솔루션이다. 서식이 제각각인 비정형 문서도 별도의 학습 데이터 구축 없이 처리하고, 도장과 서명, 표, 숫자, 기호 같은 시각 요소에서 텍스트와 키-값 데이터를 추출한다. 금융의 여신 서류부터 공공의 행정문서, 물류의 수기 운송장까지, 사람이 옮겨 적던 문서가 DEEP OCR을 거쳐 업무 데이터가 된다. 더 자세한 정보는 koreadeep.com의 DEEP OCR 페이지에서 확인할 수 있다.
한국딥러닝 소개
한국딥러닝(KDL)은 2019년 설립된 엔터프라이즈 AI 에이전트 기업이다. 자체 문서 특화 VLM 'KDL 프론티어'를 기반으로 기업과 공공기관의 문서 업무를 맡아 처리하는 AI Worker를 만든다. 주요 제품은 DEEP OCR, DEEP Parser, DEEP Agent, DEEP Ops다.
Share article
- Article text
- Article mediaDownload image
Source
- IT비즈뉴스 2022-04-26
- 아이티비즈 2022-04-26
- 데이터넷 2022-04-26
- 브릿지경제 2024-09-27
- 매일일보 2025-12-11
- EBN 2026-04-22
- EBN 2026-04-23
- ZDNet Korea 2026-10-30
- 데이터넷 2026-10-30
Media inquiries
Korea Deep Learning